503エラーとは?原因・500/502/504との違い・対処法を図解
503エラー(503 Service Unavailable)とは、Webサーバーが一時的な過負荷やメンテナンスのために、今はリクエストを処理できないことを伝えるHTTPのステータスコードです。
この記事では、RFC 9110の定義とRetry-After、原因、500・502・504との違い、閲覧者と運営者の確認手順を、ステータス行・ログ・設定値の例で図解します。

この記事は以下のような人におすすめ!
- 503エラーの意味と原因を知りたい人
- 500・502・504との違いを整理したい人
- 自分のサイトで503が出て調べ方を知りたい人
本記事はプロモーション(アフィリエイト広告)を含みます。
1-1. RFC 9110が定める503の意味
Webページを開こうとしたら、画面に「503 Service Unavailable」とだけ表示されて困ったことはありませんか。
ブラウザーがWebサーバーにページを頼むと、サーバーは返事の1行目に「HTTP/1.1 200 OK」のような3桁の番号(ステータスコード)を付けて答えます。
このうち500番台はサーバー側の問題を表す番号で、503はその中の「今は一時的に応じられない」という意味です。
次の図は、ブラウザーの要求に対してサーバーが503を返すときのやり取りを、例示用のアドレスで示したものです。
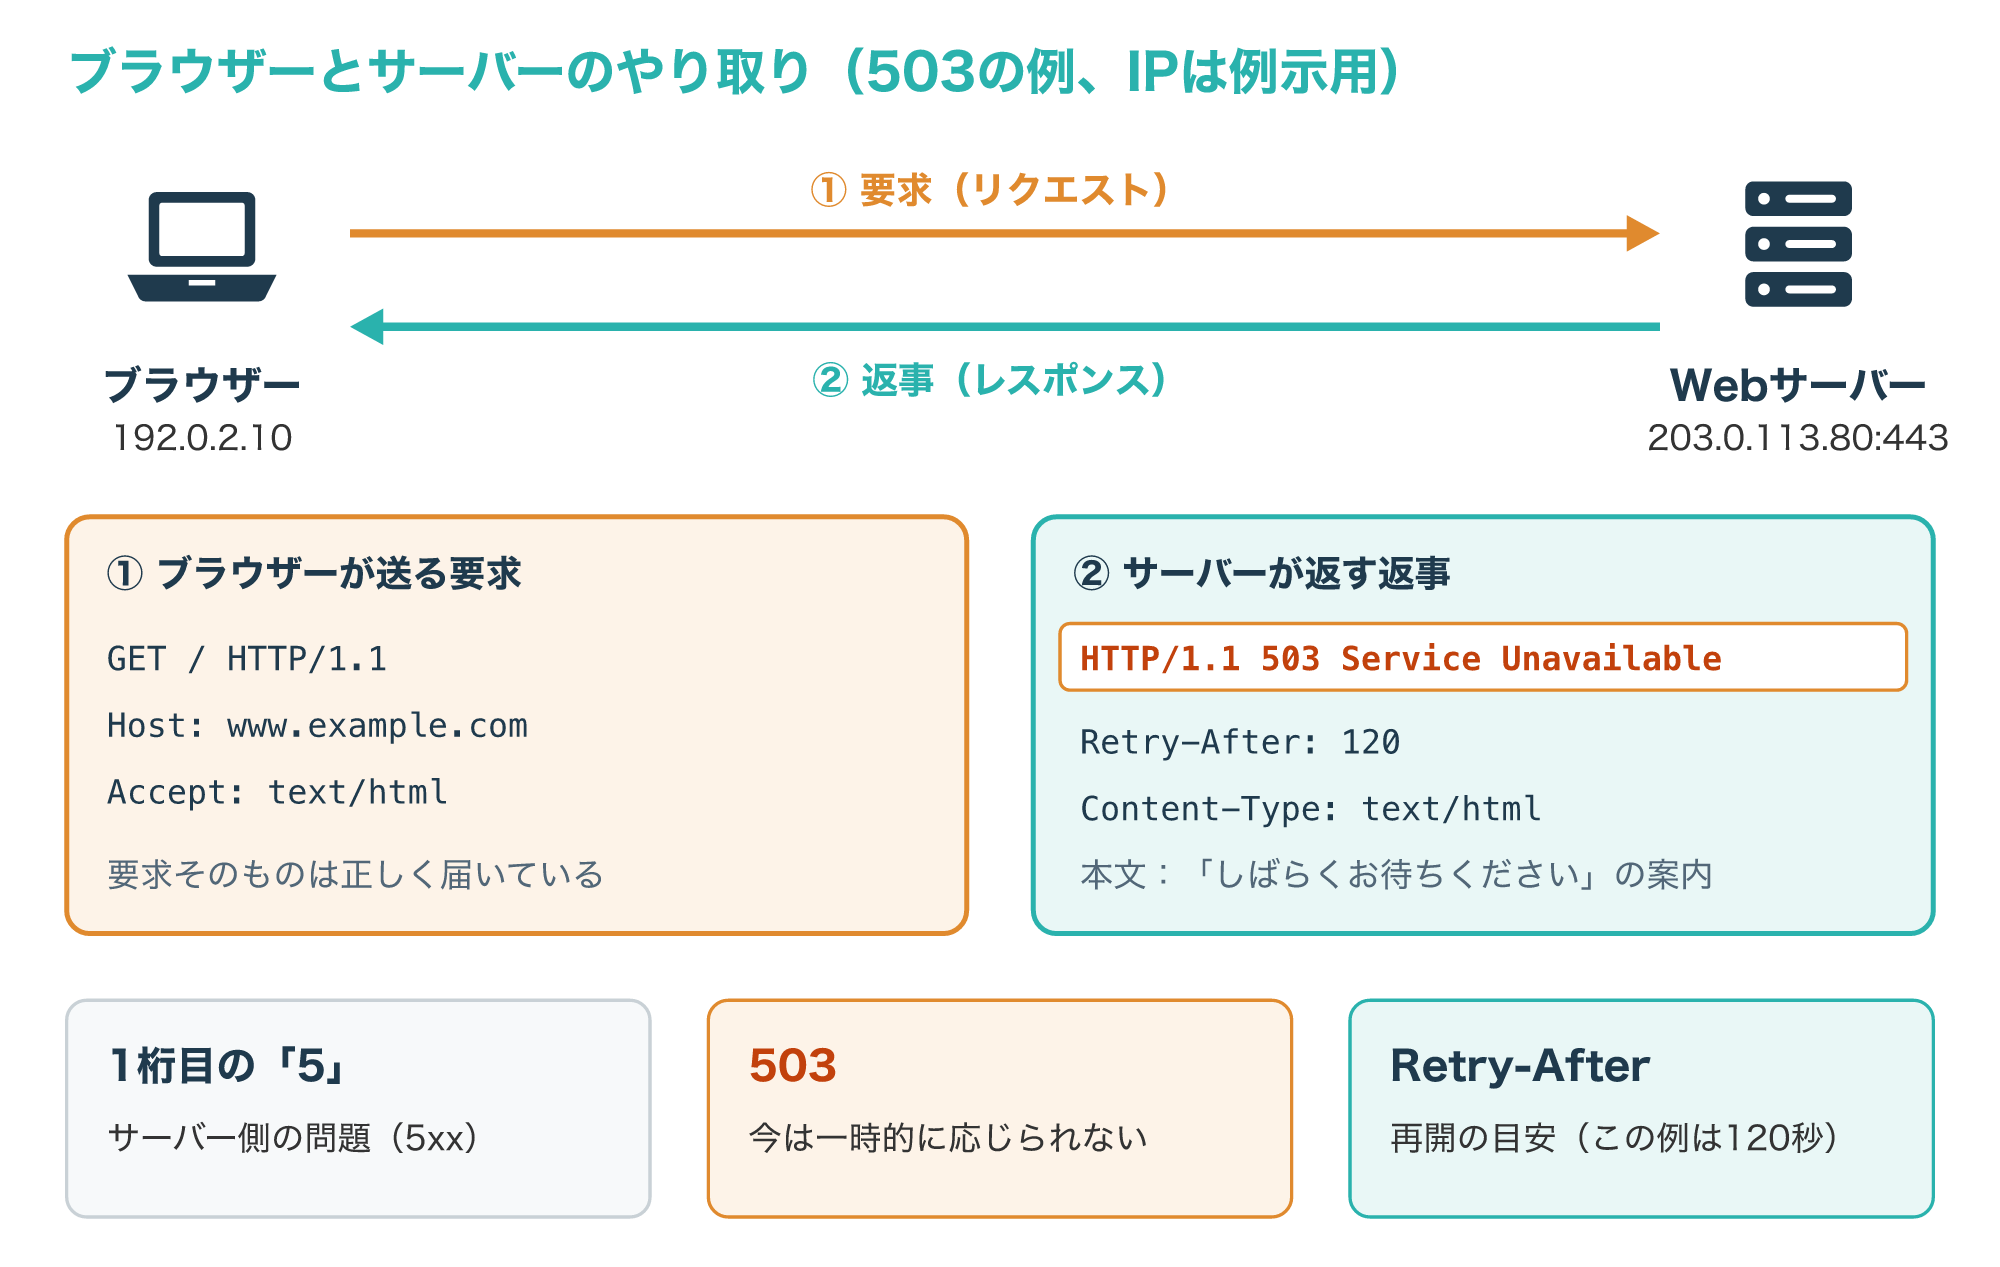
HTTPの仕様であるRFC 9110は、503を「一時的な過負荷または計画されたメンテナンスのため、サーバーが今はリクエストを処理できない状態」と定義しています。
そして、この状態は少し時間がたてば解消される見込みが高いとしています。
また、500番台の返事では、サーバーはエラーの状況と、それが一時的か恒久的かを説明する本文を付けるべきで、ブラウザーはその本文を利用者に表示するべきだとされています。
同じ仕様には、過負荷になったサーバーがいつも503を返すとは限らず、接続そのものを受け付けないサーバーもあるという注記もあります。
つまり503は「壊れて動かない」という意味ではなく、「サーバーは動いているが、今は引き受けられない」とサーバー自身が答えている状態です(参考1)。
1-2. Retry-Afterヘッダーで再開の目安を伝える
503の返事には、Retry-Afterというヘッダー(返事に付ける追加情報)を付けて、いつごろ再開できそうかを伝えられます。
次の図は、Retry-Afterの2つの書き方と、それを受け取ったクライアントが待ってから再び要求する流れの例です。
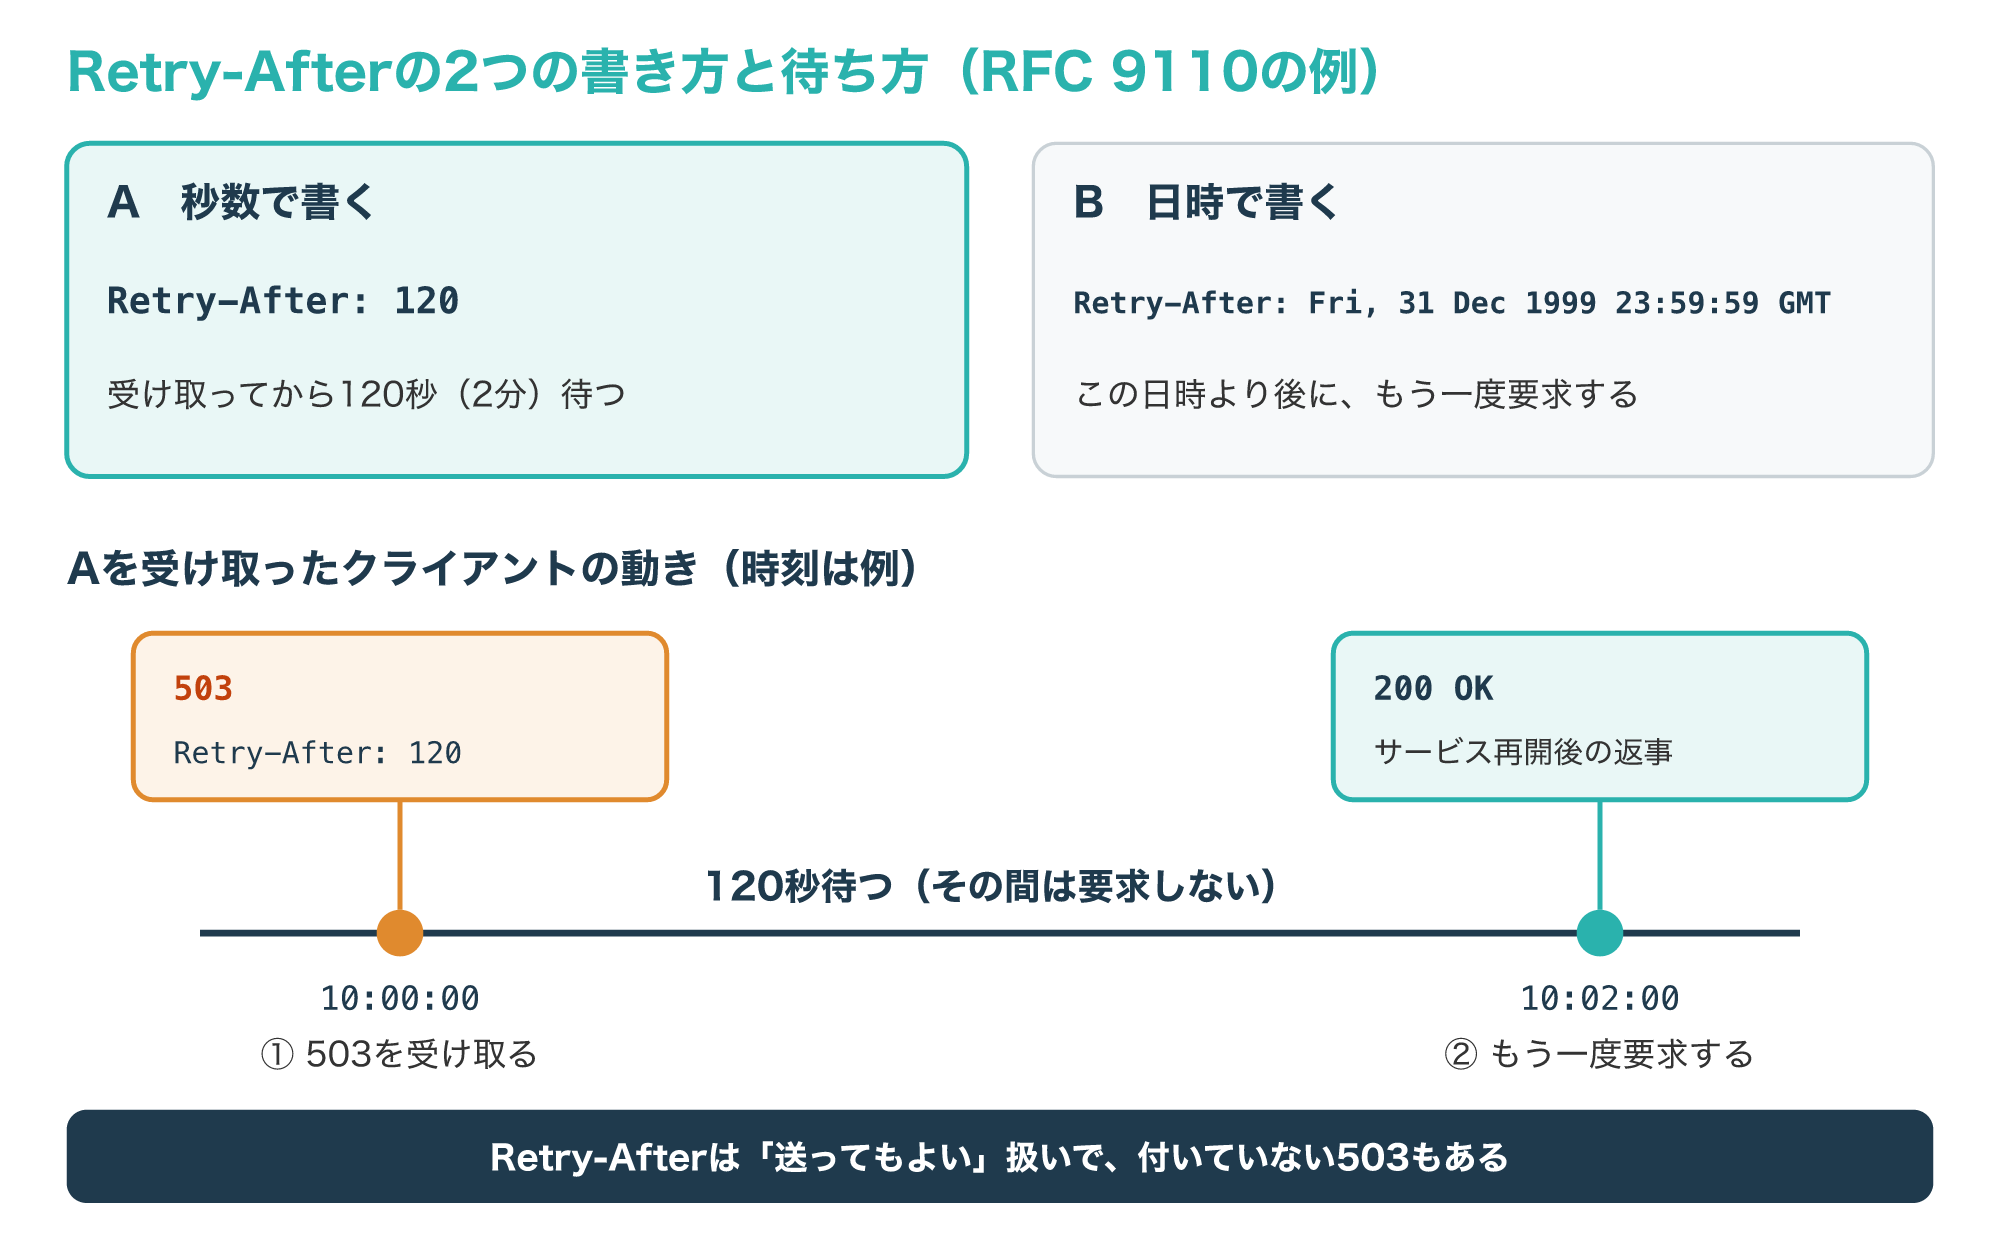
RFC 9110では、Retry-Afterの値は「Retry-After: 120」のような秒数か、「Retry-After: Fri, 31 Dec 1999 23:59:59 GMT」のような日時のどちらかで書きます。
503と一緒に送った場合、Retry-Afterは「そのサービスがクライアントにとって使えない見込みの時間」を表します(参考1)。
MDNも、503は一時的な状態に使い、できればRetry-Afterに復旧までの見込み時間を入れ、問題を説明するわかりやすいページを一緒に返すよう勧めています(参考2)。
ただしRFC 9110ではRetry-Afterは「送ってもよい(MAY)」という扱いで、付いていない503も珍しくありません。
また、値はあくまで目安なので、指定の時刻を過ぎても直っていないことがあります。
503エラーが起きる主な原因
503は1つの故障を指す番号ではなく、「受け付けられない」理由はいくつもあります。
次の図は、Webサイトを支える仕組みのどこで、どんな理由から503が返るかを整理したものです。
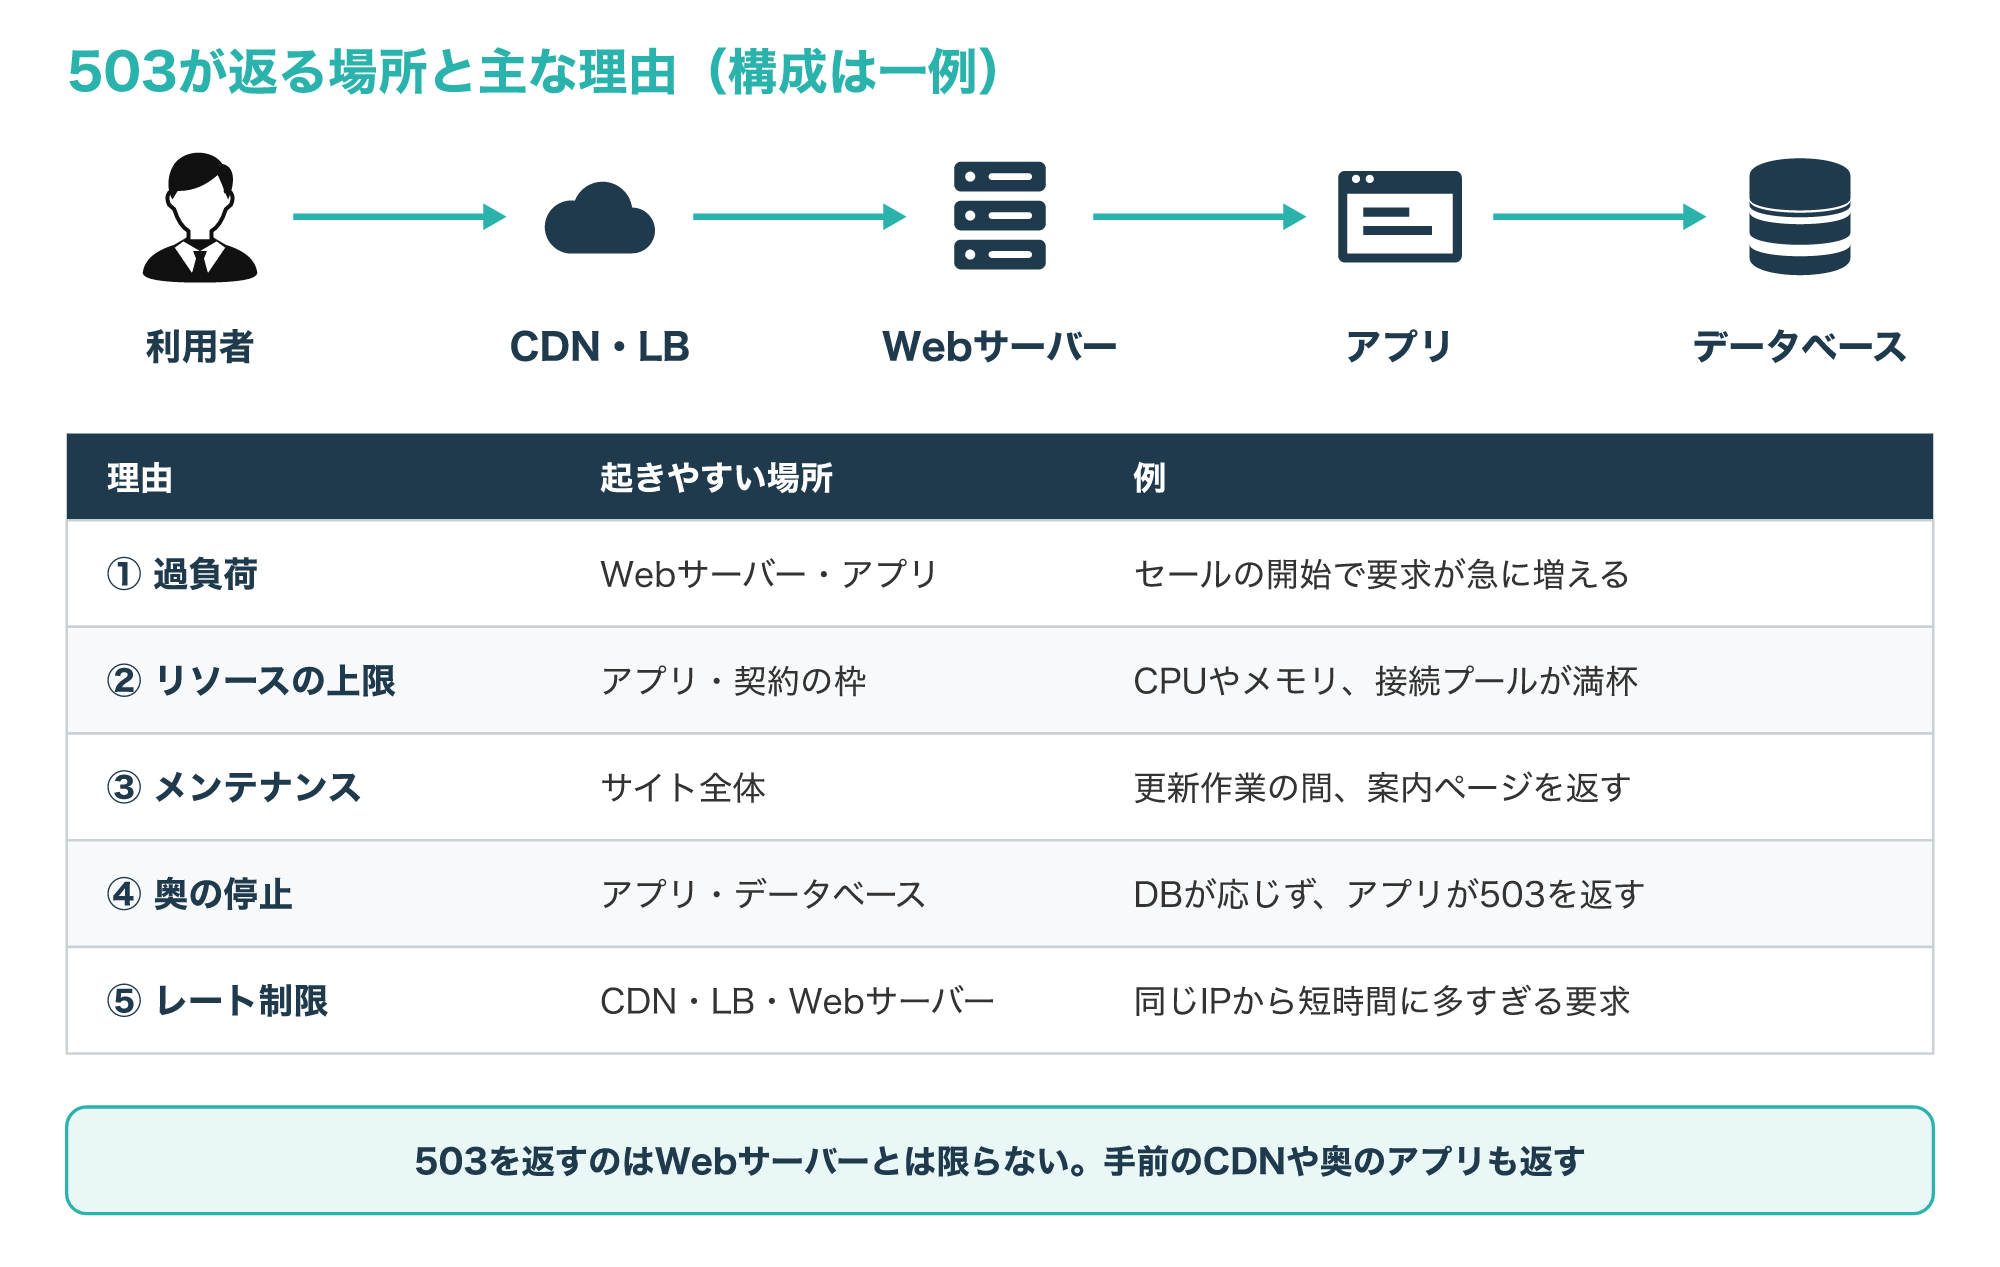
図のように、503を返すのはWebサーバーだけとは限らず、手前のCDNやロードバランサー、奥のアプリが返すこともあります。
ここからは、5つの理由を3つの節に分けて見ていきます。
2-1. 過負荷とリソースの上限
最も典型的な原因は、アクセスが急に増えて、サーバーの処理能力を超えてしまうことです。
MDNは、アプリによってはメモリやCPU、接続プール(データベースなどへの接続を使い回すための枠)の上限に達すると503で要求を断ると説明しています。
これは、無理に受け付けて全体が止まるより、一部を断って計算資源を守るための仕組みです(参考2)。
ただし、Webサーバー自身が上限に達したときの動きは、ソフトによって違います。
次の図は、Apacheの同時処理数の上限(MaxRequestWorkers)を超えた接続と、アプリの接続プールが満杯になった場合の違いを示した例です。
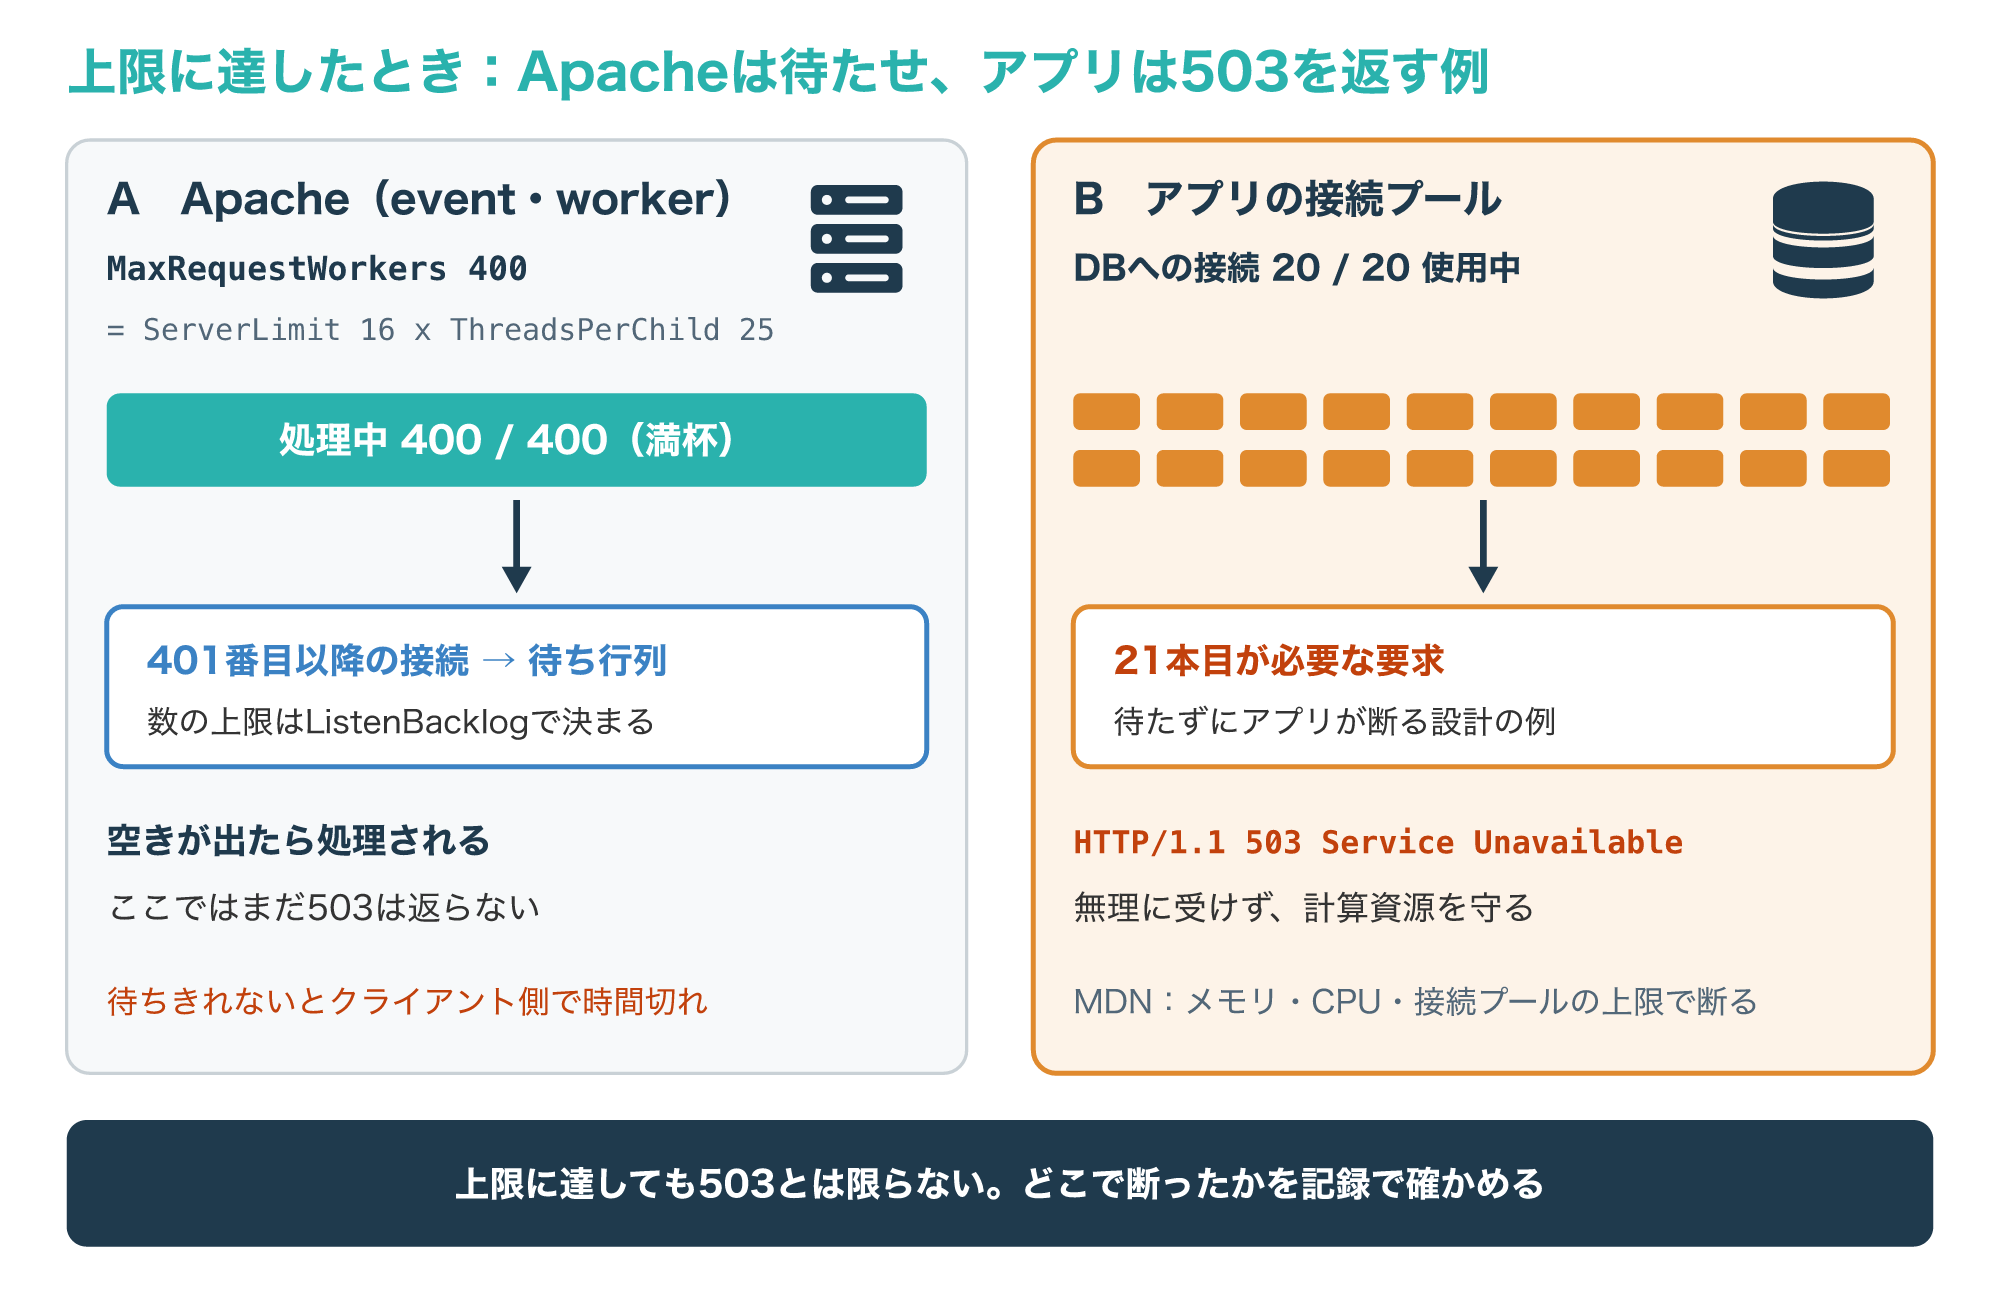
Apacheの資料では、MaxRequestWorkersを超えた接続は、ふつうはListenBacklogで決まる数まで待ち行列に入り、ほかの処理が終わって空きが出たら処理されると説明されています。
上限の既定値は、スレッドを使うeventやworkerでは16(ServerLimit)×25(ThreadsPerChild)の400、preforkでは256です(参考6)。
つまりApacheが上限に達しても、すぐに503が返るのではなく、まず待たされ、待ちきれなかったクライアント側で時間切れになることがあります。
一方で、図のアプリのように接続プール20本がすべて使用中なら、アプリが自分の判断で503を返すことがあります。
共用のレンタルサーバーでは、契約ごとにCPUやメモリ、同時に動かせるプロセスの数などの上限が決められていることが多く、それを超えたときの応答は事業者ごとに異なります。
2-2. 計画メンテナンスとデプロイ
2つ目の原因は、運営者が意図して受付を止める計画メンテナンスです。
RFC 9110の定義にも「計画されたメンテナンス」がはっきり含まれていて、作業中の一時的な停止を伝えるのは503の本来の使い方です(参考1)。
MDNによると、メンテナンス中はすべての通信を503のページへ回すことがあり、ソフトの更新中に自動で503になる場合もあります(参考2)。
たとえばWordPressなどのCMSを更新している間や、新しい版のアプリを配置(デプロイ)してプロセスを入れ替える間に、短い503が出ることがあります。
この場合は作業が終われば自然に直るので、閲覧者は少し待つだけで済みます。
メンテナンスの開始と終了の予定を前もってお知らせしておくと、閲覧者は503を見ても慌てずに済みます。
運営者にとっては、作業中に返す503とRetry-Afterの組み合わせを正しく設計しておくことが大切で、その方法は6-1で解説します。
2-3. バックエンドの停止とレート制限
3つ目は、Webサーバーの奥にあるアプリやデータベースが止まっているケースです。
手前のリバースプロキシ(利用者の代わりに奥のサーバーへ要求を取り次ぐサーバー)は動いていても、取り次ぐ先が応じなければページは表示できません。
このとき何番が返るかは構成によって違い、奥のアプリ自身が503を返せば、それがそのまま利用者に届きます。
4つ目は、同じ相手から短い時間に多すぎる要求が来たときに断るレート制限です。
次の図は、nginxのlimit_reqで「1秒に1回、ためておけるのは5回まで」と決めたときに、同じIPから一度に7回の要求が来た場合の例です。
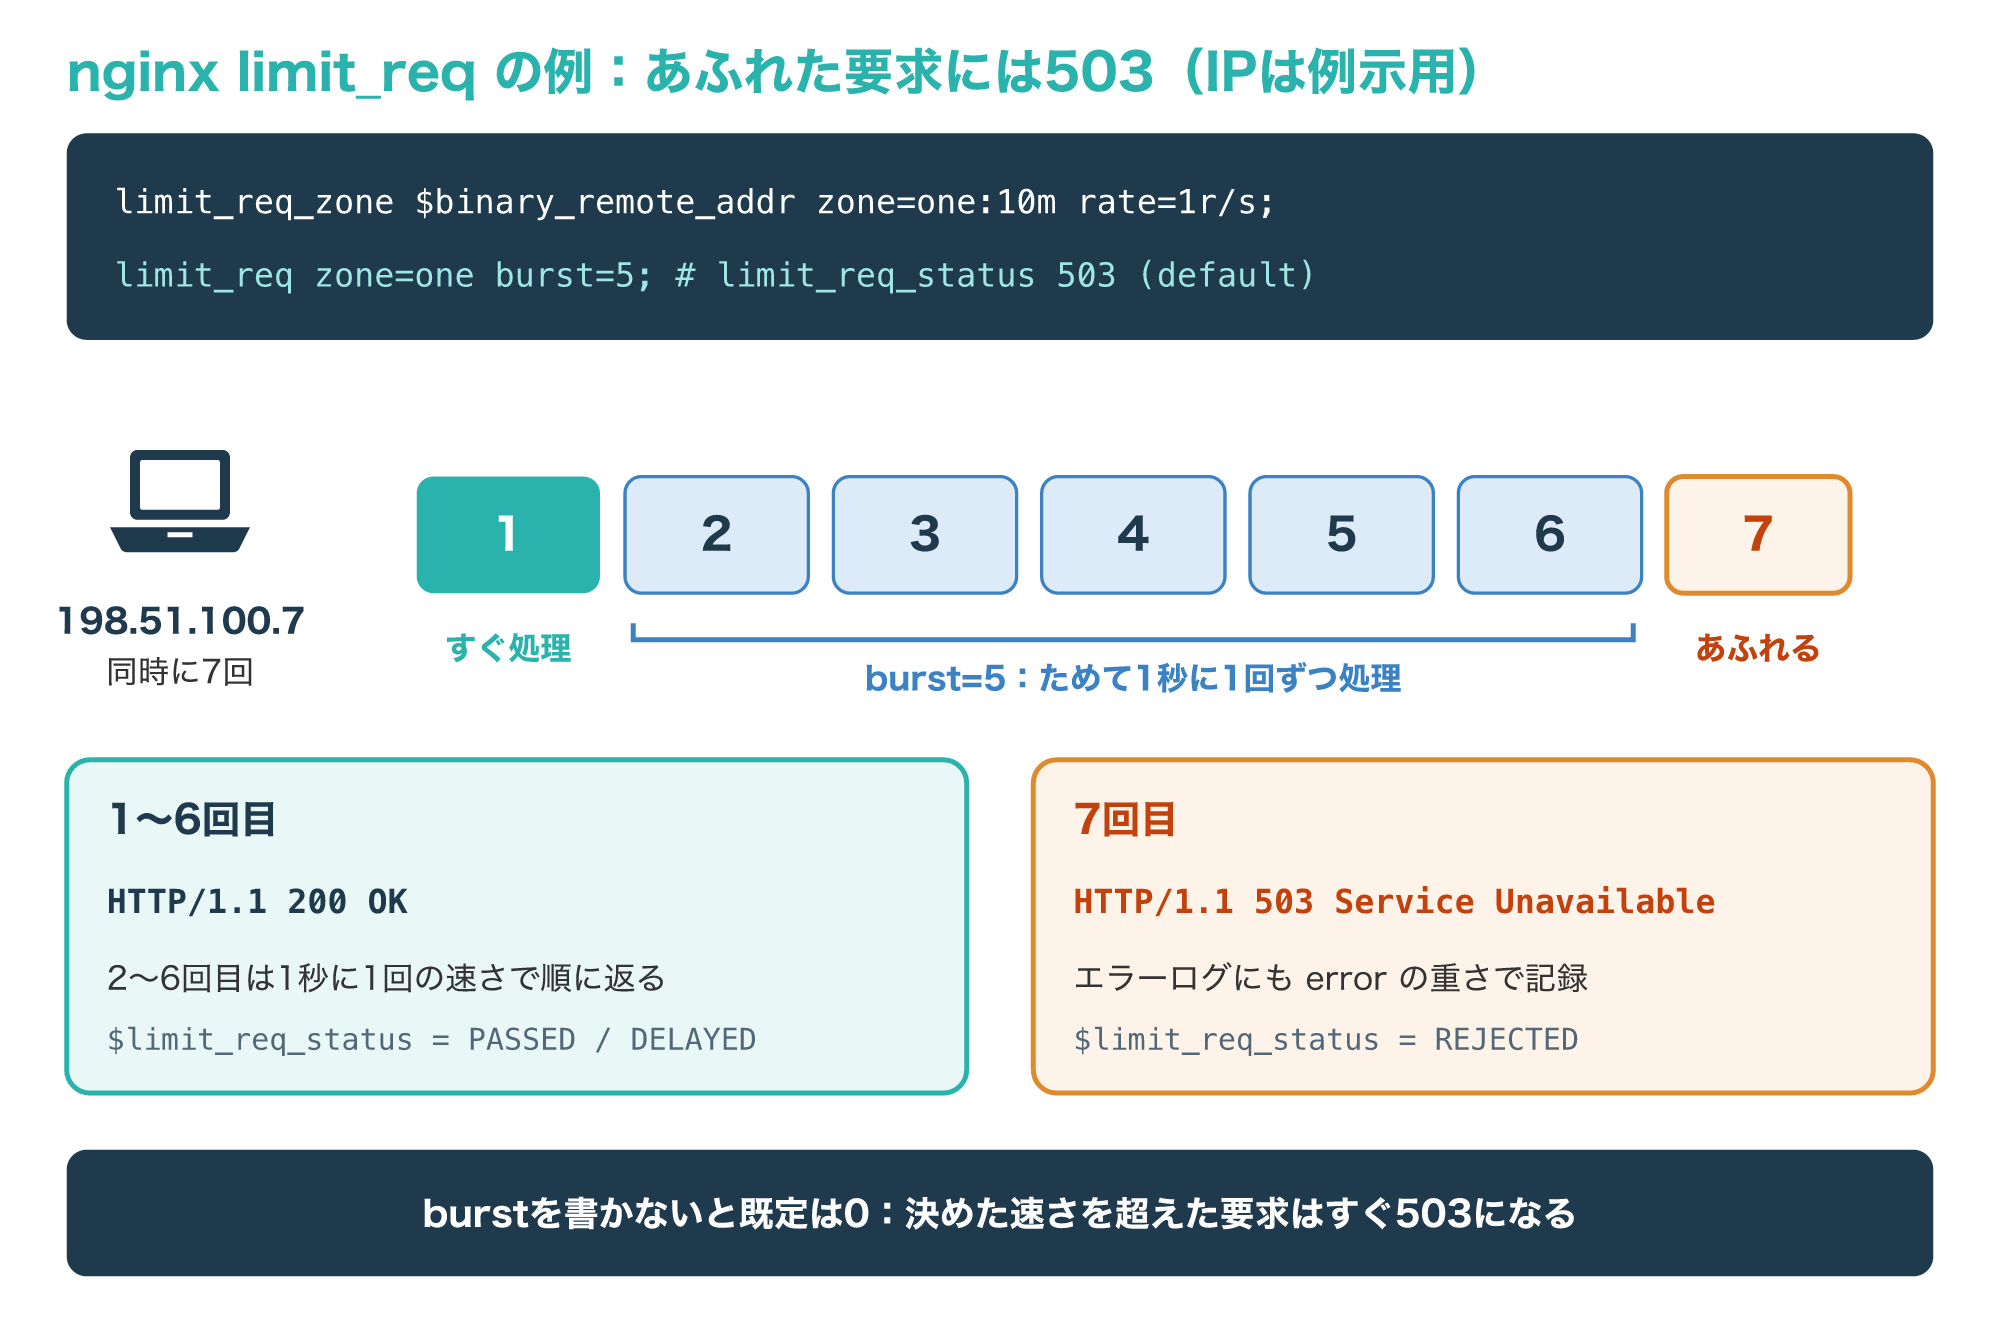
nginxのlimit_reqは「漏れバケツ」と呼ばれる方式で、決めた速さ(例 rate=1r/s)を超えた要求をいったんためて、その速さで順に処理します。
ためておける数(burst)を超えた要求はエラーで打ち切られ、そのとき返す番号を決めるlimit_req_statusの既定値は503です。
ためておける数の既定値は0で、burstを書かなければ、速さを超えた要求はすぐに断られます。
送信元ごとの状態を覚えておく共有メモリ(zone)は、64ビット環境では1MBあたり約8,000件を記録でき、図の10mなら約8万件です。
zoneがいっぱいになると最も長く使われていない記録から消し、それでも新しい記録を作れないときは、その要求もエラーで打ち切られます(参考3)。
ただしMDNは、特定のクライアントの要求をレート制限で断る場合には、503ではなく429 Too Many Requestsが適切だとしています(参考2)。
大量のアクセスで受付をあふれさせるDDoS攻撃を受けたときも、過負荷やレート制限の結果として503が出ることがあり、攻撃の仕組みは次の記事で解説しています。
500・502・504・429との違い
3-1. どこで失敗したかで番号が変わる
500番台の番号は、どれも「サーバー側で何かがうまくいかなかった」ことを表しますが、どこで何が起きたかが違います。
次の図は、ブラウザーからリバースプロキシ、アプリ、データベースへとつながる構成で、それぞれの番号がどこで生まれるかを示したものです。
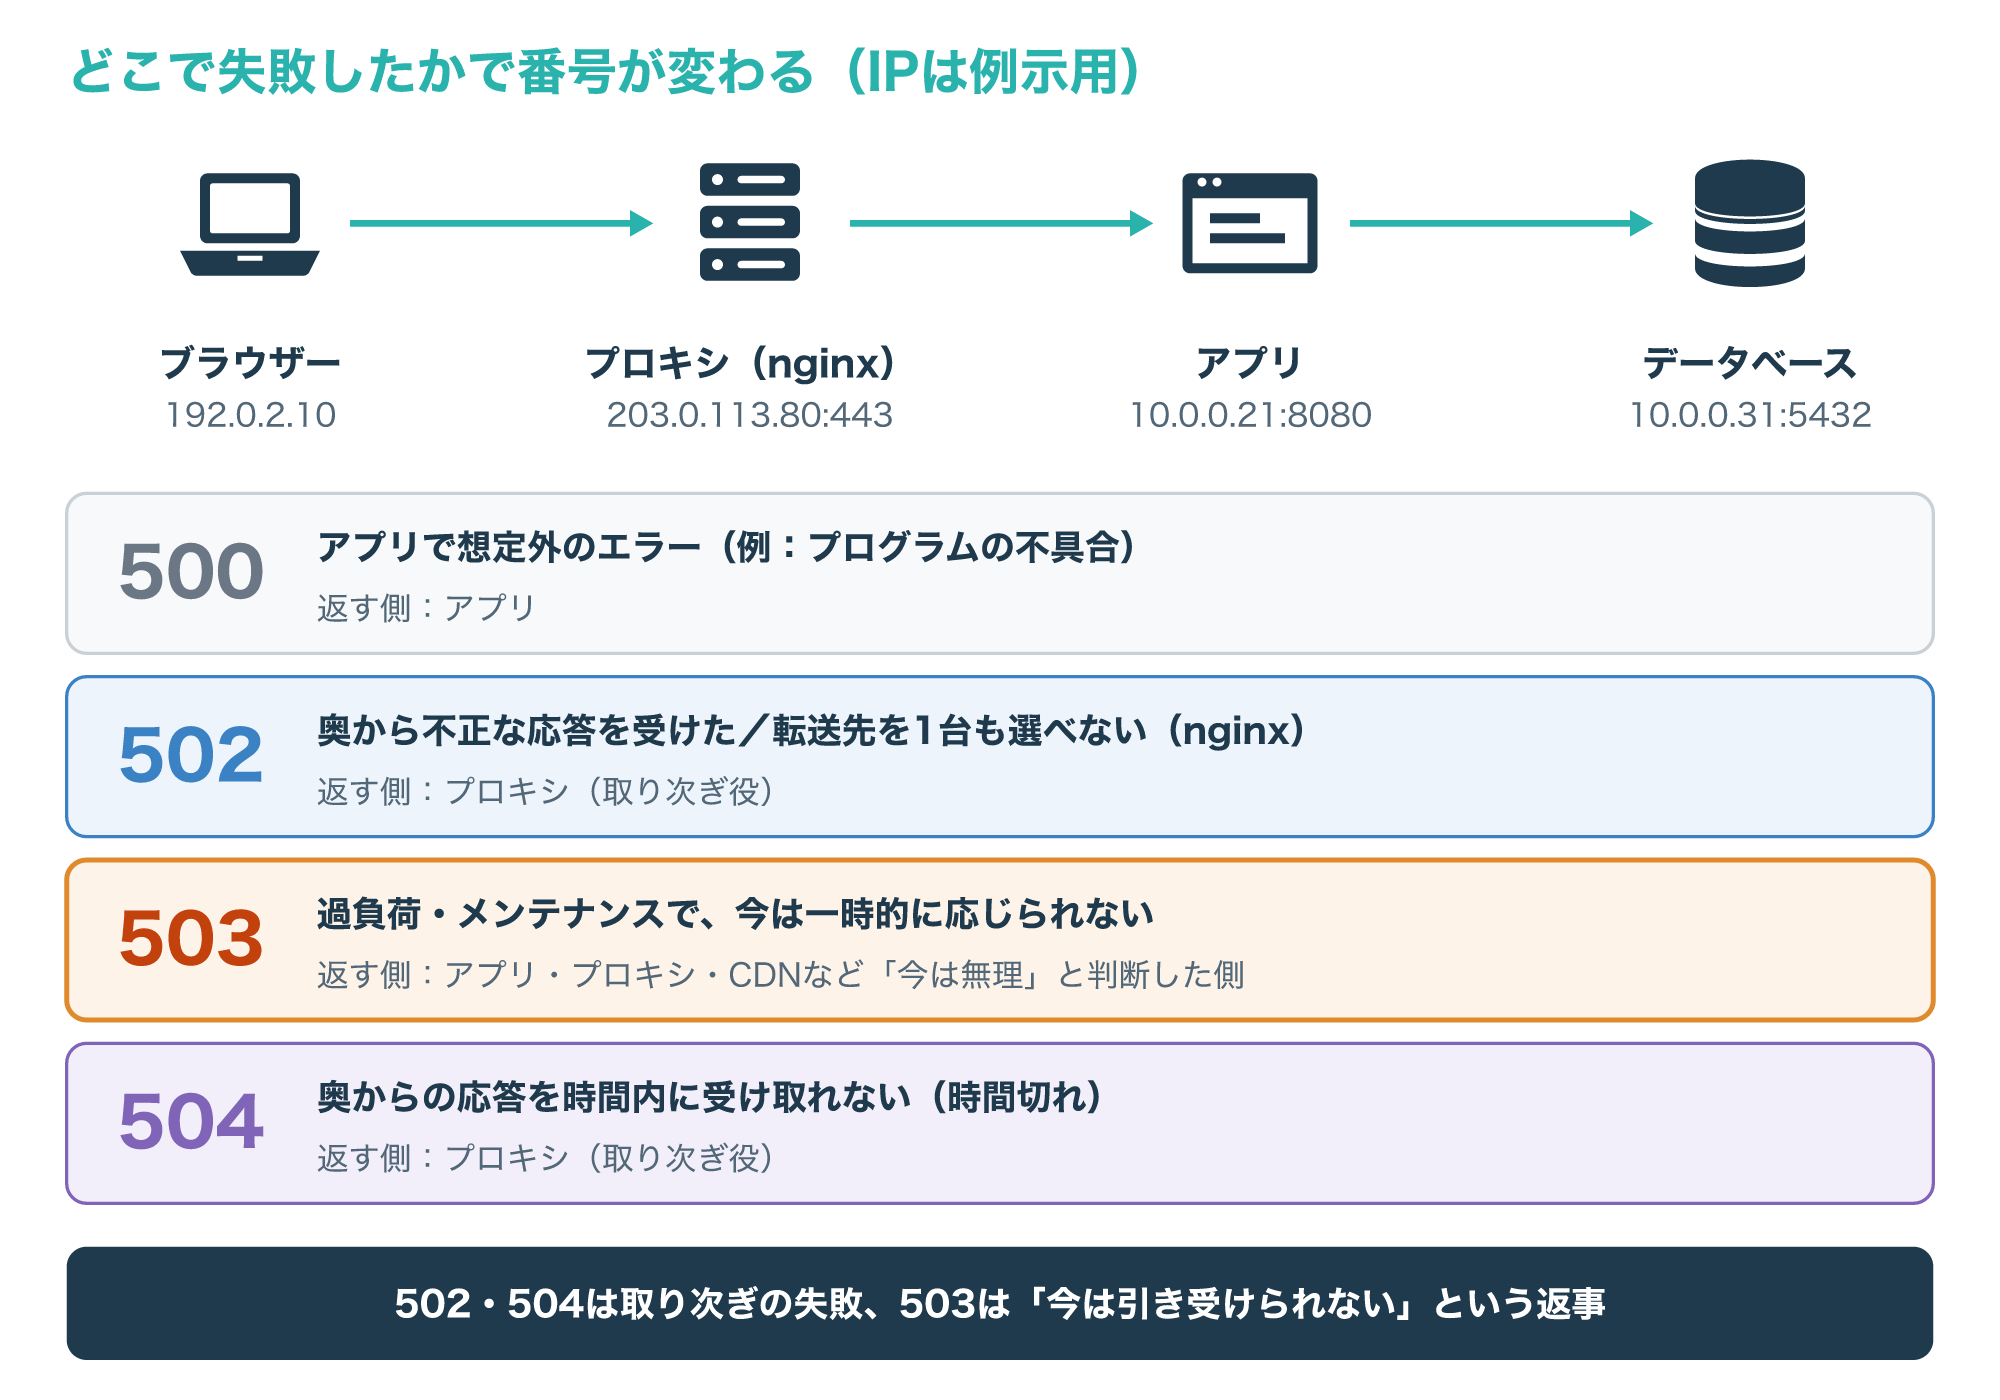
RFC 9110では、500は「想定外の状態が起きて要求を処理できなかった」ことを表し、アプリの不具合などで使われます。
502は、ゲートウェイやプロキシとして動くサーバーが、奥のサーバーから不正な応答を受け取ったことを表します。
504は、ゲートウェイやプロキシとして動くサーバーが、奥のサーバーから時間内に応答を受け取れなかったことを表します(参考1)。
これに対して503は、取り次ぎかどうかに関係なく「今は一時的に引き受けられない」ことを伝える番号です。
同じ構成でも、プロキシの前にCDNやロードバランサーがあれば、そこで503や502が返ることもあるため、どの機器が返した番号かを記録で確かめることが大切です。
注意したいのは、奥のサーバーが全部止まったときにどの番号を返すかが、ソフトによって違う点です。
nginxの資料では、転送先のサーバーを1台も選べないときは、記録用の変数$upstream_statusに502が入り、待ち行列(queue)があふれたときも502を返すと説明されています(参考4)。
リバースプロキシの役割や仕組みをもう少し詳しく知りたい方は、次の記事も参考にしてください。
3-2. 429と503の使い分け
レート制限の場面では、503と429のどちらを返すかで迷うことがあります。
次の表は、503・429と、よく比べられる500・502・504の違いを、利用者から見た意味と運営者が最初に見る場所で整理したものです。
| 番号 | 意味 | 運営者が最初に見る場所 |
|---|---|---|
| 500 | アプリの想定外のエラー | アプリのエラーログ |
| 502 | 奥から不正な応答、転送先なし | プロキシのエラーログと奥の稼働 |
| 503 | 今は一時的に応じられない | 負荷・上限・メンテナンスの状態 |
| 504 | 奥からの応答が時間切れ | 奥の処理時間とタイムアウト値 |
| 429 | その利用者の要求が多すぎる | レート制限の設定と対象のIP |
MDNの説明に沿うと、サーバー全体が混んでいて誰の要求も受けにくいなら503、特定の利用者だけを回数で制限しているなら429が向いています(参考2)。
nginxのlimit_reqは既定で503を返しますが、limit_req_statusで返す番号を変えられるため、429に変えて「あなたの要求が多すぎる」と伝える運用もできます(参考3)。
どちらを返すにしても、Retry-Afterで待つ時間を伝えると、行儀のよいクライアントは間隔を空けてくれます。
閲覧者側にできること
4-1. 自分だけか全体かを切り分ける
503はサーバー側の事情を伝える番号なので、閲覧者のパソコンやスマホの設定で直せることは多くありません。
それでも、自分だけに起きているのか、サイト全体で起きているのかを確かめると、待つべきか、別の手を打つべきかが見えてきます。
次の図は、503が表示されたときに閲覧者が確かめる順番の例です。
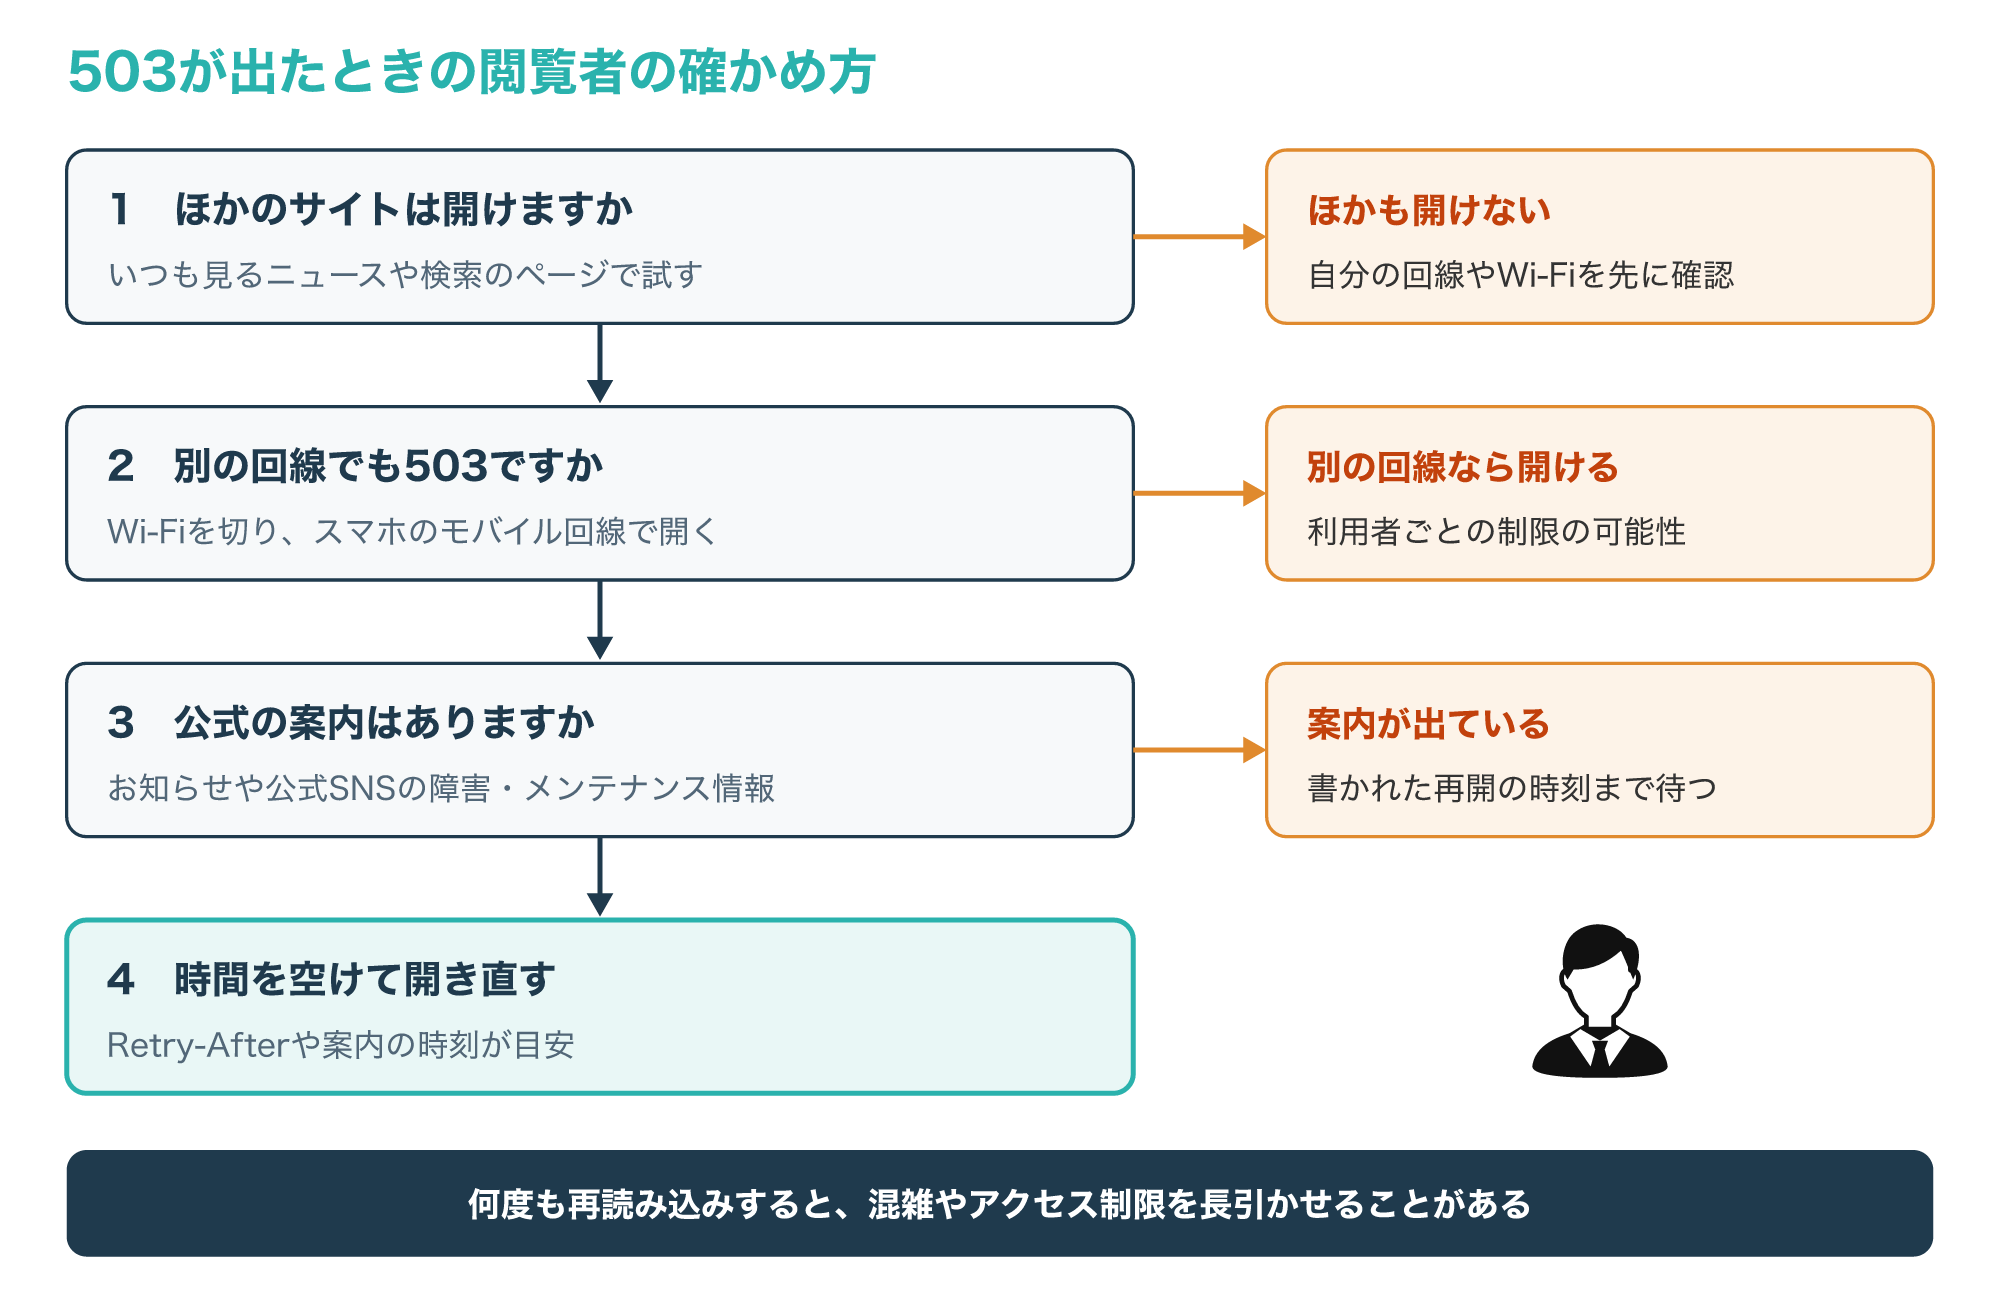
ほかのサイトも開けないなら、503ではなく自分の回線やWi-Fiの問題を先に疑います。
特定のサイトだけが503なら、スマホのモバイル回線など別の回線から開いてみて、同じ結果かを比べます。
別の回線では開けるなら、同じIPアドレスからの要求が多すぎてアクセスを制限されているなど、利用者ごとの制限にかかっている可能性があります。
どの回線でも503なら、サイト側の障害やメンテナンスの可能性が高いので、公式サイトのお知らせや公式SNSで案内が出ていないかを確かめます。
4-2. 再読み込みは間隔を空ける
503が出たときに、再読み込みのキーを何度も押したくなる気持ちはよくわかります。
しかし、混雑が原因の503なら、短い間隔で何度も要求すると、サーバーの負担を増やすことになります。
案内ページにRetry-Afterや再開の時刻が書かれていれば、その時間まで待ってから開き直すのが近道です。
レート制限にかかっている場合は、連続で要求するほど制限が続くこともあるため、数分は間を空けましょう。
買い物や申し込みの途中で503が出たときは、注文が通ったかどうかをメールやマイページで確かめてから操作をやり直すと、二重の申し込みを防げます。
長時間直らず、そのサイトを仕事で使っている場合は、サイトの問い合わせ窓口に、表示された時刻と画面の内容を伝えると調査の助けになります。
サイト運営者の確認手順
5-1. アクセスログで503の時間帯と範囲を見る
自分のサイトで503が出たら、まずアクセスログで「いつから、どのページで、どれくらいの割合で」起きているかを確かめます。
nginxの既定の記録形式(combined)は、送信元のIP、日時、要求の1行、ステータスコード、送ったバイト数、参照元、ブラウザーの情報を1行に並べたものです。
次の図は、combined形式のアクセスログに503が混じっている例と、そこから読み取れることを示したものです。
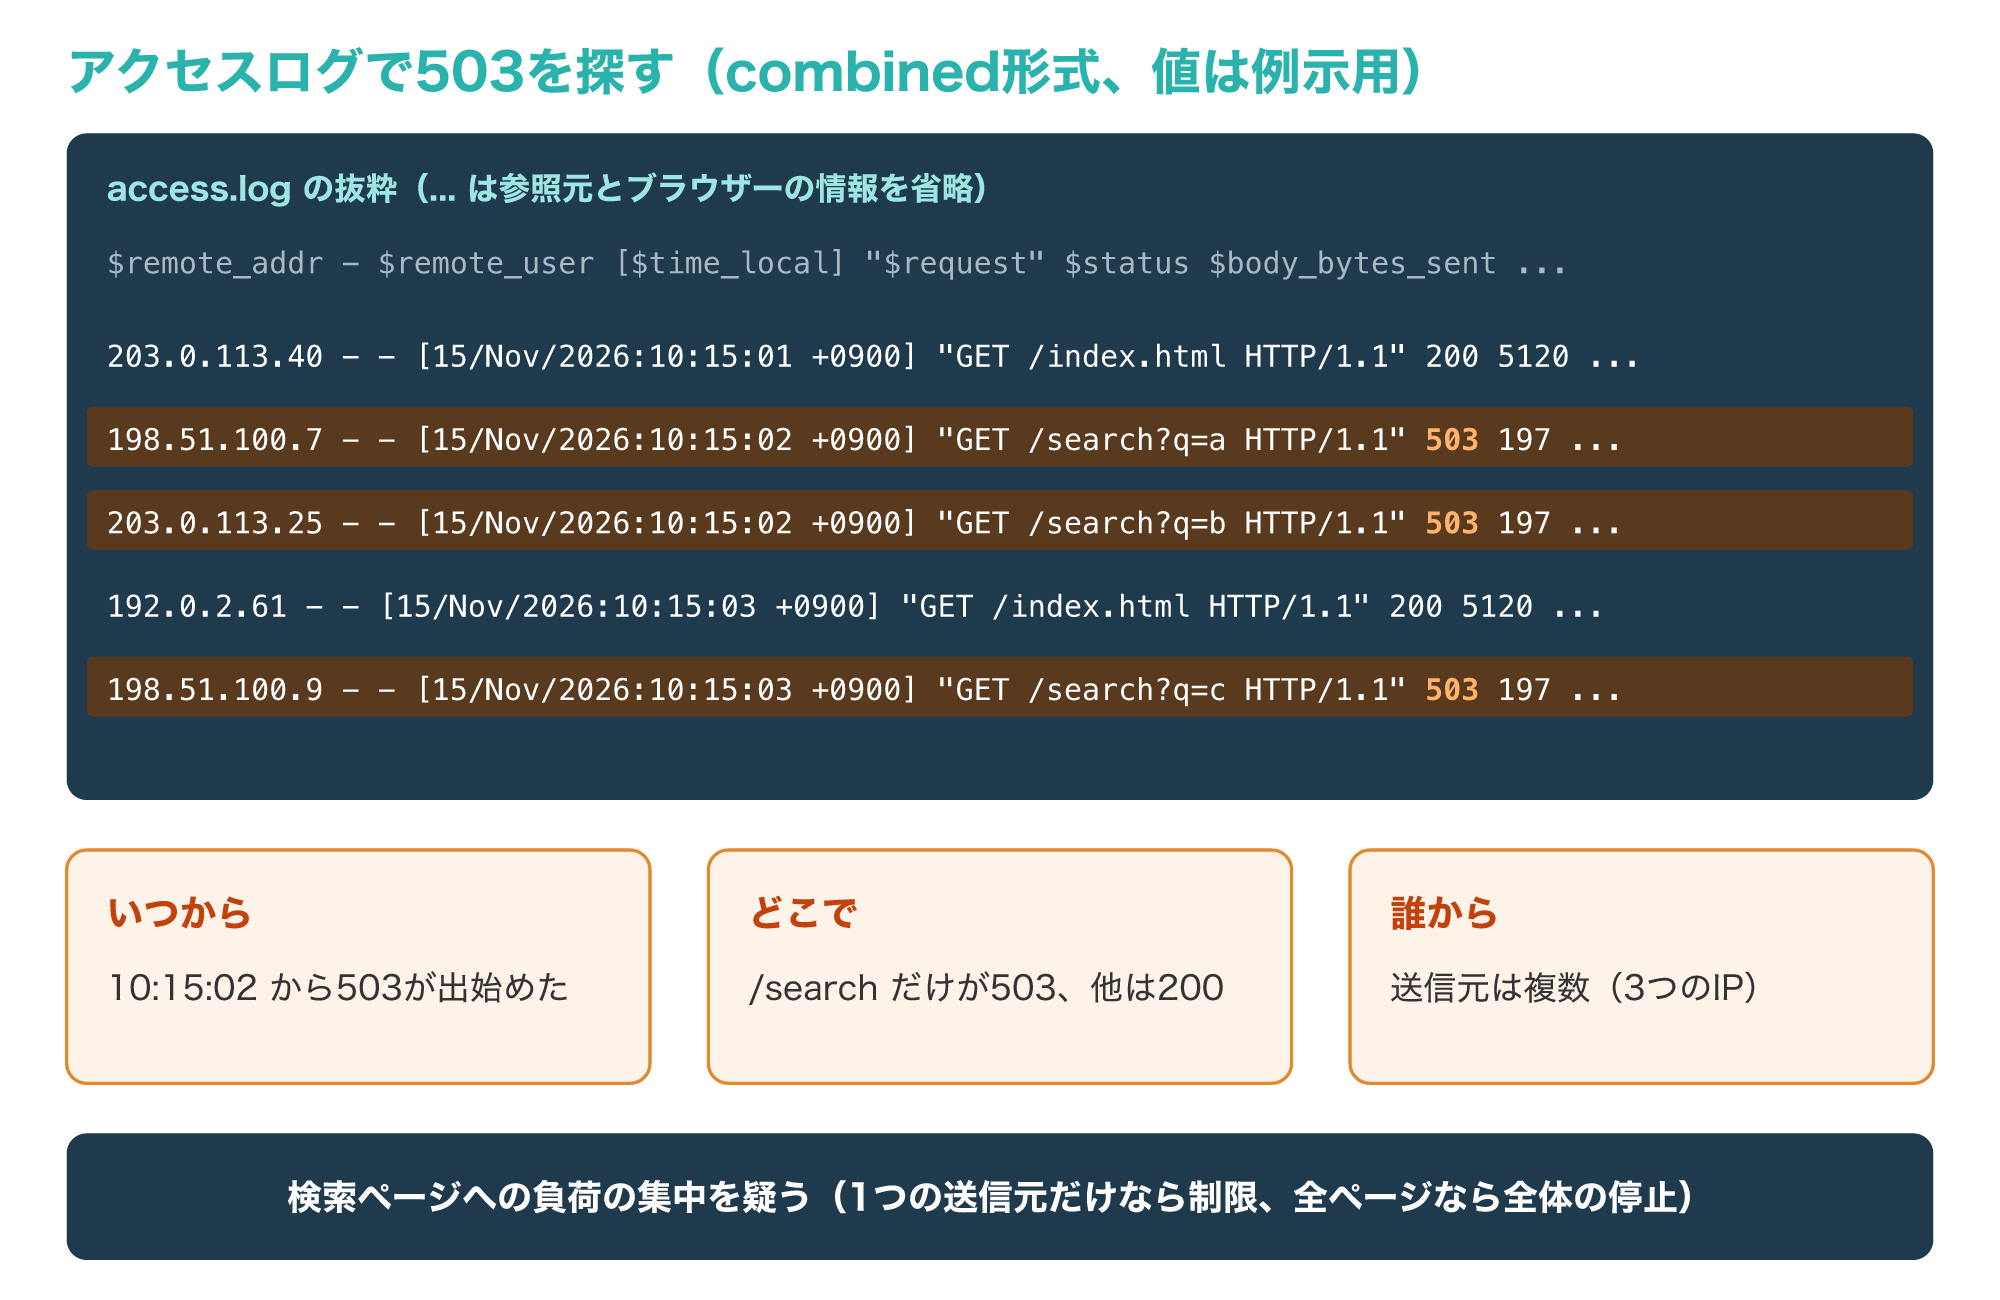
図の例では、10時15分2秒から/searchへの要求だけが503になり、送信元も複数なので、検索ページに負荷が集中していると見当を付けられます。
反対に、1つの送信元からの要求だけが503なら、レート制限やアクセス制限にかかった可能性を先に調べます。
すべてのページが同じ時刻から503なら、メンテナンスの設定が残っている、アプリ全体が止まっているなど、サイト全体の原因を疑います。
記録形式に$request_timeを加えると、要求の最初のバイトを読んでから返事を送り終えるまでの時間が秒(ミリ秒の精度)で残るため、503の前に処理が遅くなっていなかったかも確かめられます。
nginxでは、ステータスコードが2xxと3xxの行を記録しない条件付きの記録もできるため、エラーだけを別のファイルに集めると探しやすくなります(参考5)。
5-2. 503を返したのが誰かを特定する
次に、503を返したのがnginx自身なのか、奥のアプリなのかを区別します。
そのためには、記録形式に上流(奥のサーバー)の応答と、レート制限の結果を加えておくと便利です。
次の図は、記録形式に$upstream_statusなどの変数を加えたときの3つの記録例と、その読み方を示したものです。
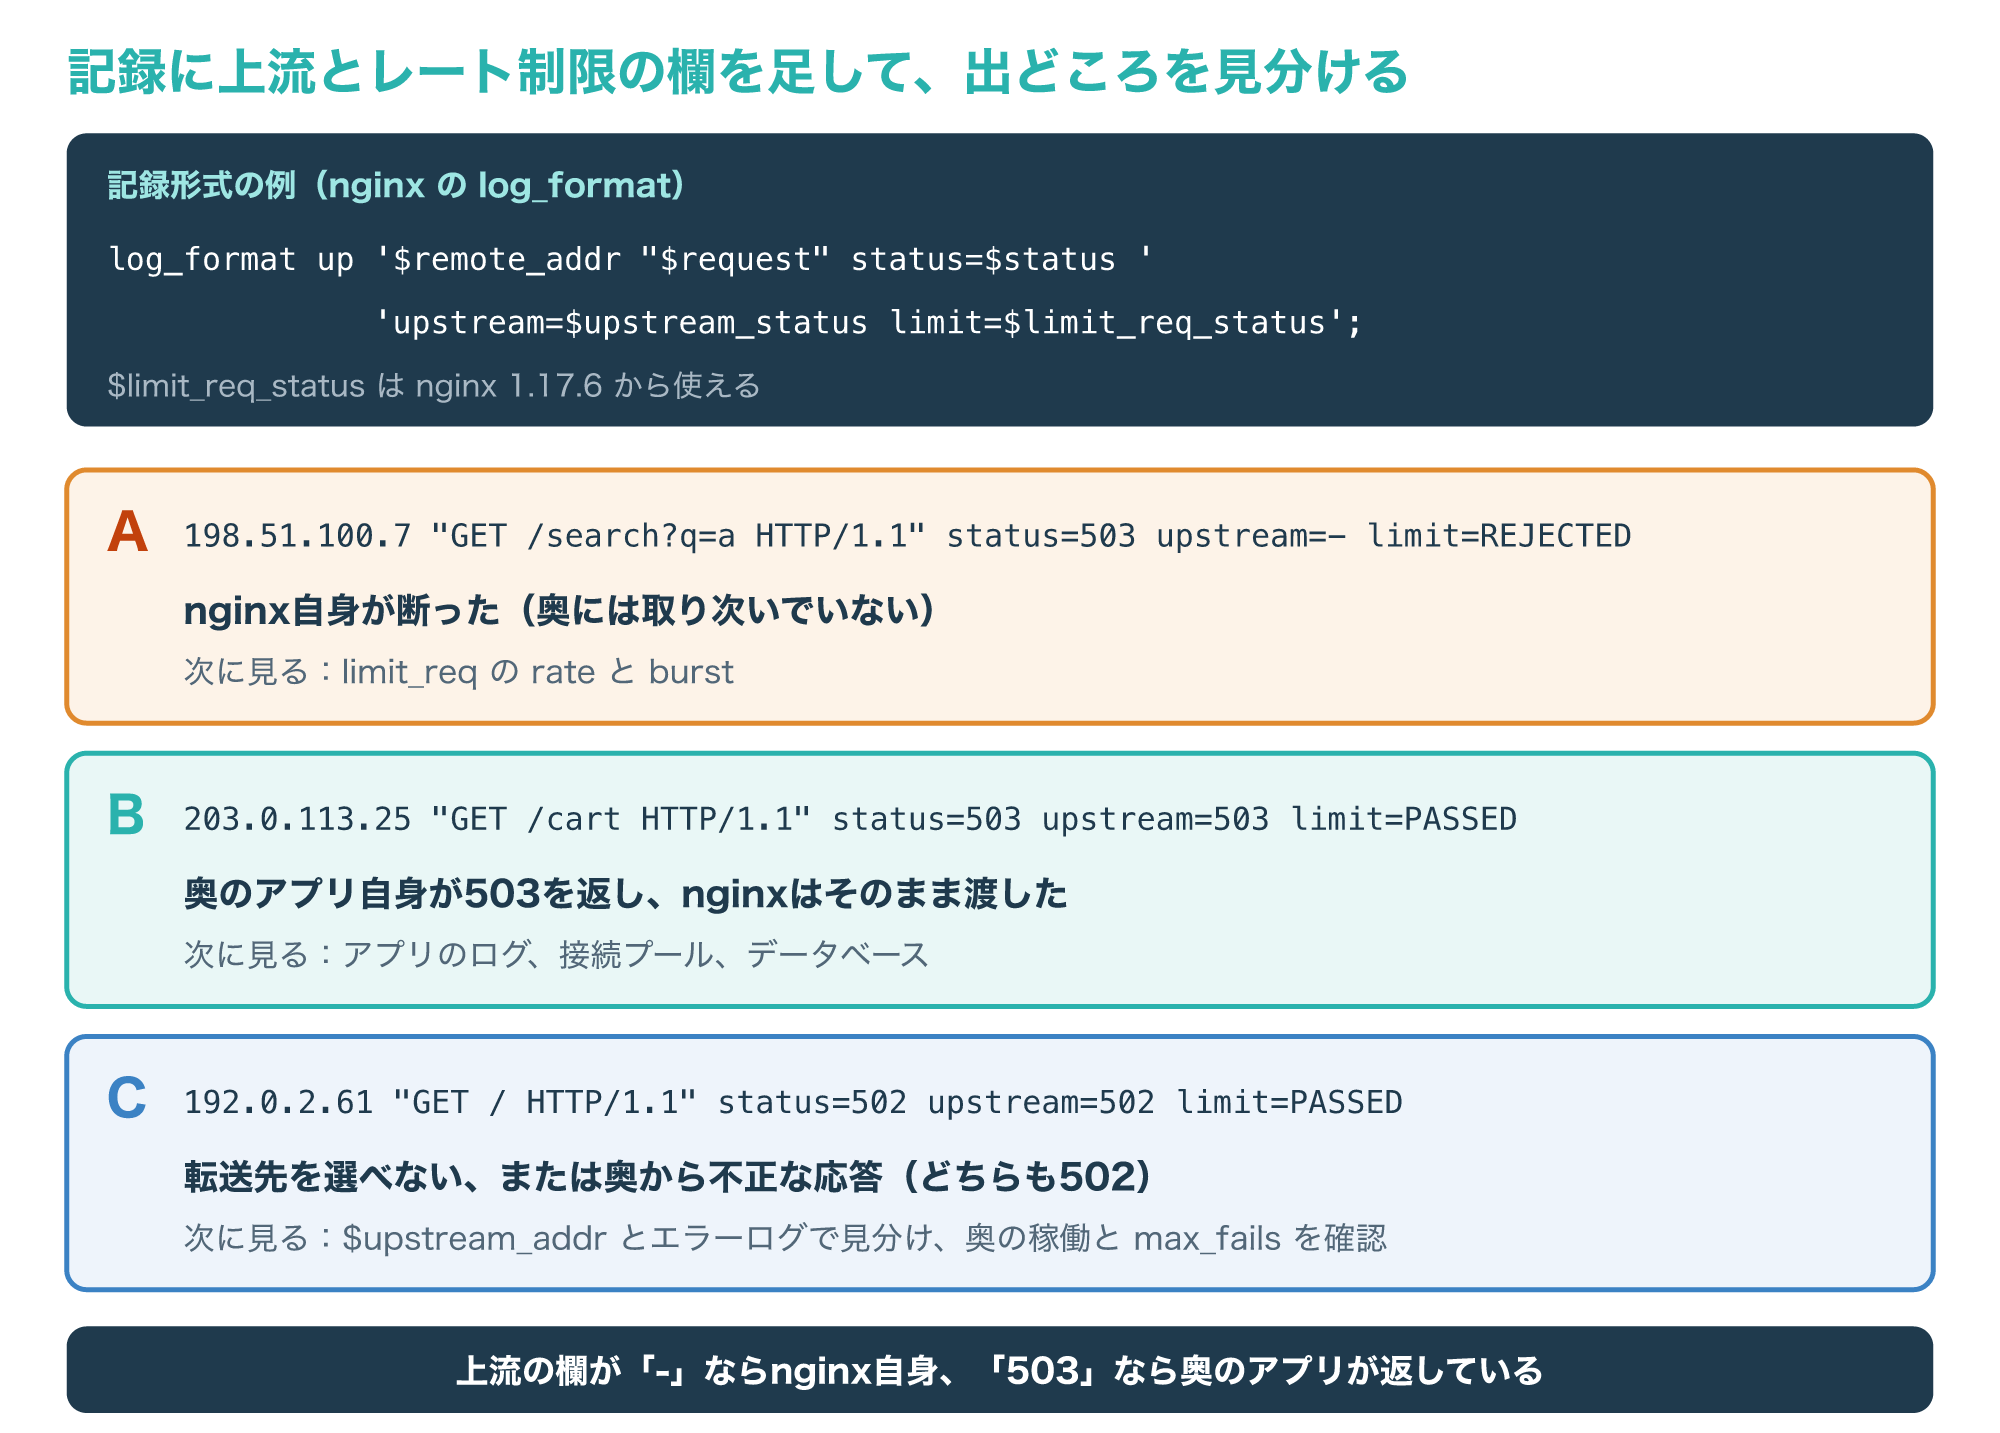
$upstream_statusには奥のサーバーから受け取ったステータスコードが入り、$upstream_addrには取り次いだ先のアドレスが入ります。
$upstream_response_timeには奥のサーバーから返事を受け取るまでの時間が入るので、503の前に奥の処理が遅くなっていなかったかを見るのにも役立ちます(参考4)。
図のBのように、$upstream_statusも503なら、503を返したのは奥のアプリなので、アプリのログや接続プール、データベースの状態を調べます。
$limit_req_statusにはレート制限の結果がPASSED・DELAYED・REJECTEDなどで入るため、図のAのようにREJECTEDなら、nginxのlimit_reqが断ったと判断できます。
この変数はnginx 1.17.6から使え、limit_reqで断った出来事は、既定ではerrorの重さでエラーログにも残ります(参考3)。
Cのように502で上流の欄も502なら、3-1で見たとおり転送先を選べなかったか、奥から不正な応答を受けた可能性があり、$upstream_addrやエラーログで見分けながら503とは別の場所を調べます。
5-3. nginx・Apacheの設定値を見直す
出どころがわかったら、関係する設定値が今のアクセス量に合っているかを確かめます。
次の図は、503や似たエラーに関わるnginxとApacheの主な設定項目と、資料に書かれた既定値をまとめたものです。
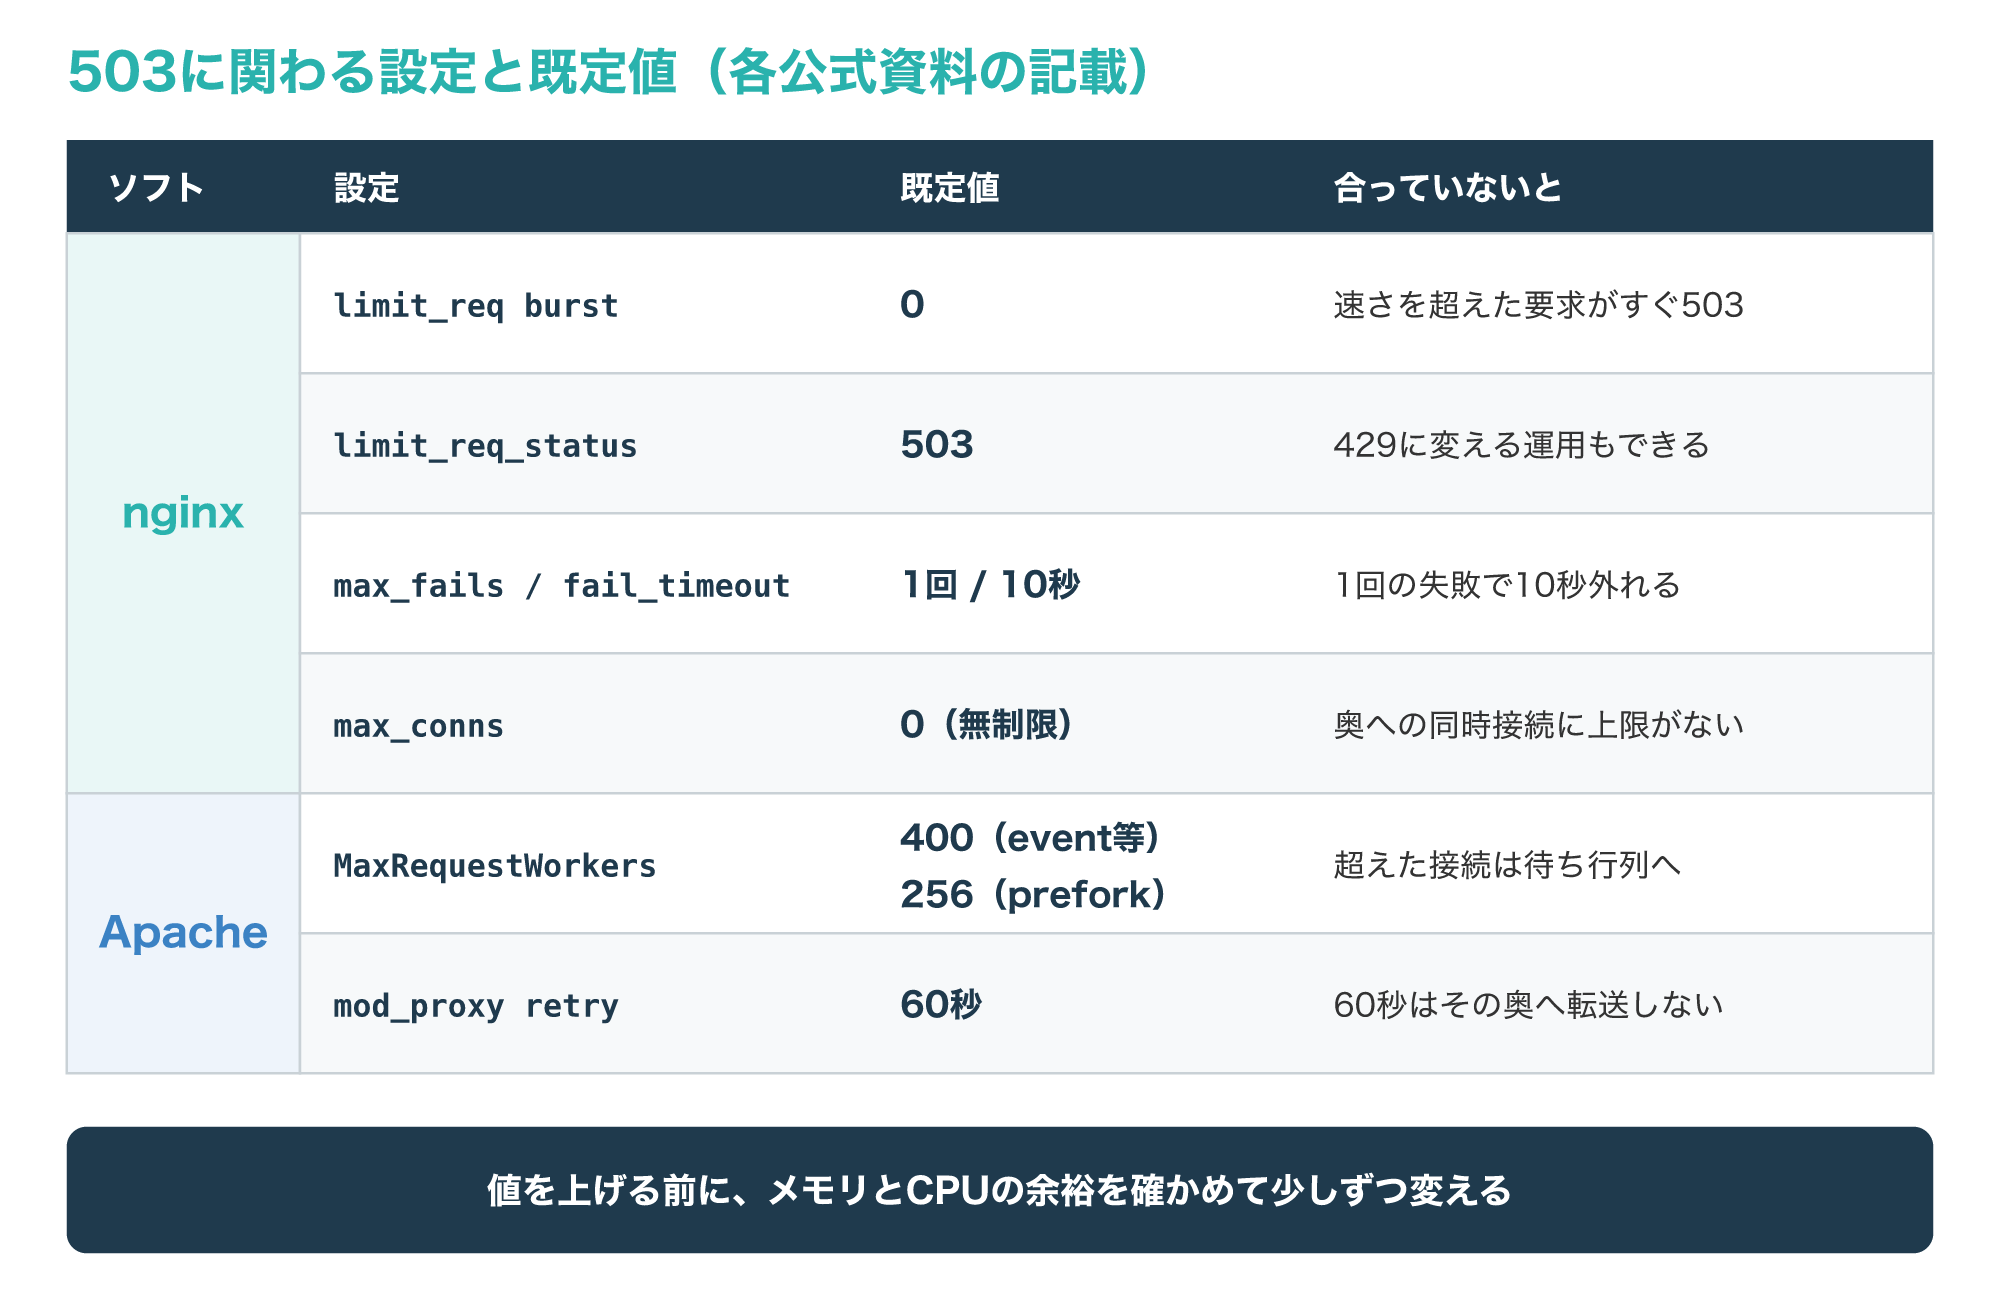
nginxのlimit_reqで正常な利用者まで断っているなら、rateやburstが実際のアクセスの波に対して小さすぎないかを見直します。
limit_req_dry_runをonにすると、実際には制限せずに、制限した場合の数だけを数えられるので、値を変える前の試しに使えます(参考3)。
nginxのupstreamでは、max_failsの既定値は1、fail_timeoutの既定値は10秒で、この時間内に決めた回数だけ失敗したサーバーは、同じ時間だけ使えないものとして外されます(参考4)。
Apacheでは、同時に処理できる数の上限であるMaxRequestWorkersを上げるときに、ServerLimitも一緒に上げる必要があることがあります(参考6)。
Apacheのmod_proxyでは、奥のサーバーがエラーの状態になると、retryの秒数(既定60秒)がたつまでそのサーバーへ転送しません。
この仕組みは奥のサーバーをメンテナンスで止めて後から戻すときにも使え、特定のステータスコードを受け取ったらエラーの状態にするfailonstatusという設定もあります(参考7)。
値を上げるときは、メモリやCPUに余裕があるかを先に確かめ、一度に大きく変えずに少しずつ調整しましょう。
503を減らす設計とサーバーの見直し
6-1. メンテナンス中は503とRetry-Afterを返す
計画メンテナンスの間に、案内ページを「200 OK」で返したり、別のページへ転送したりしている例があります。
しかし、200で返すと「正常なページ」として扱われ、検索エンジンや監視の仕組みが一時的な停止だと判断しにくくなります。
次の図は、メンテナンス中の返し方として望ましい例と、避けたい例を比べたものです。
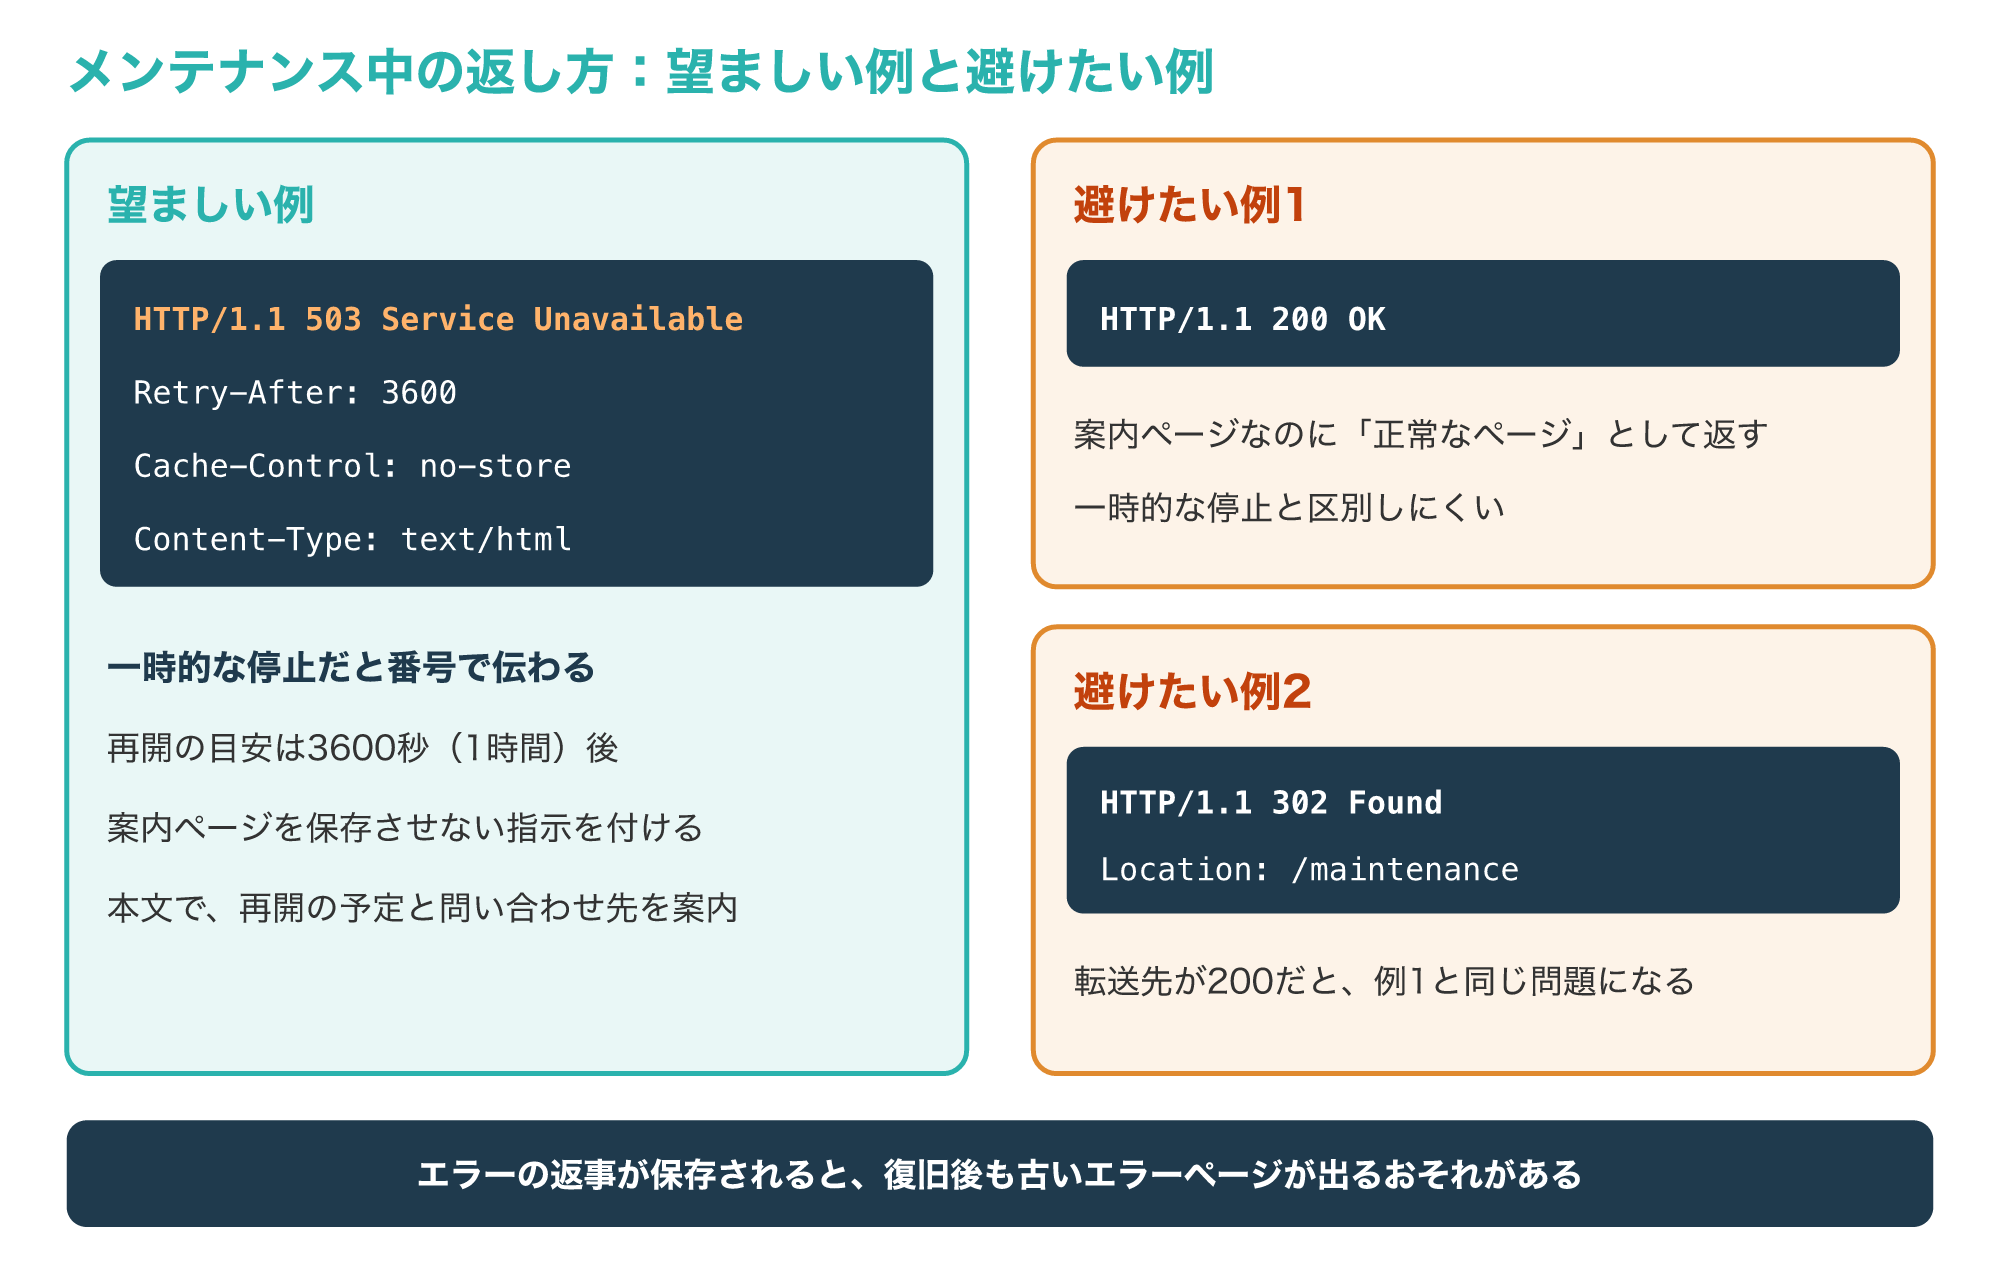
RFC 9110の定義どおり、計画メンテナンスで一時的に止めるなら503を返し、終わる見込みの時刻がわかればRetry-Afterで伝えます(参考1)。
MDNは、503は一時的な問題を表すため、ふつうは返事を保存(キャッシュ)させるべきではないとし、保存を指示するヘッダーには特に注意するよう述べています。
保存されてしまうと、復旧した後も古いエラーページが表示されるおそれがあるからです。
そのため、案内ページにはCache-Control: no-storeなど保存させない指示を付け、CDNを使っている場合はエラーの返事を保存する設定になっていないかも確かめます。
案内ページに、MDNの例のような問い合わせ用の識別子(例 request ID: ABC-123)を載せておくと、利用者からの連絡とサーバーのログを突き合わせやすくなります(参考2)。
メンテナンスの間だけ案内ページを返す控えのサーバーを用意する方法もあり、nginxのupstreamでは、backupを付けたサーバーは主なサーバーが使えないときだけ要求を受け、downを付けたサーバーは使えないものとして扱われます(参考4)。
Apacheのmod_proxyにも、ほかに使えるワーカーがないときだけ使うホットスタンバイ(status=+H)という設定があります(参考7)。
CDNが返事を保存して配る仕組みと設定の考え方は、次の記事で解説しています。
6-2. リソースの上限に当たるならサーバーを見直す
アクセスが増えるたびに503が出るなら、設定の調整だけでなく、サーバーの能力そのものが足りているかを見直す時期です。
次の図は、レンタルサーバーの管理画面などで、503が出た時間帯に何が上限に達していたかを確かめる例です。
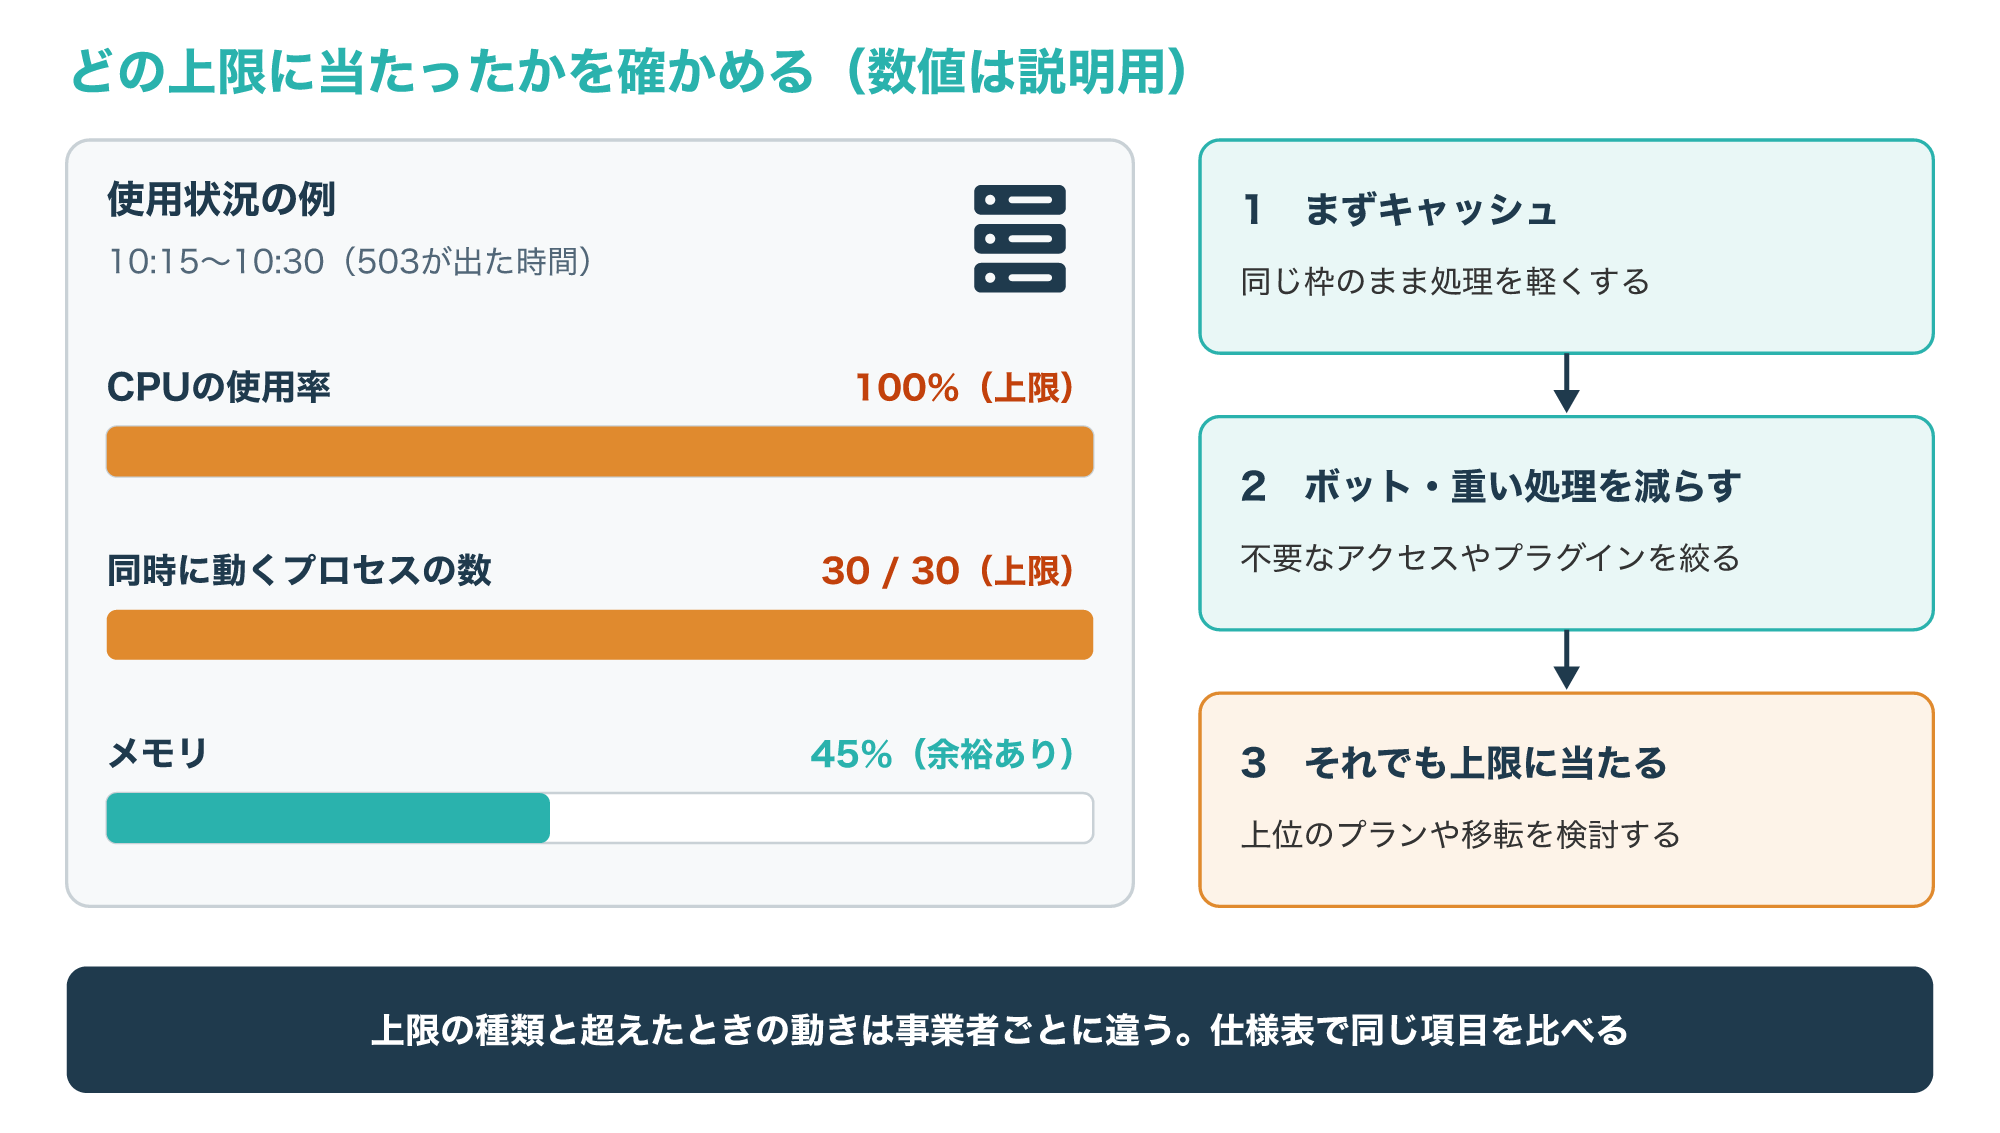
図の例のように、503が出た時間にCPUの使用率や同時に動くプロセスの数が上限に張り付いていれば、アクセスに対して契約の枠が足りていないと考えられます。
まずはページの保存(キャッシュ)を有効にする、重いプラグインや不要なボットからのアクセスを減らすなど、同じ枠で処理を軽くする方法を試します。
それでも上限に当たり続ける場合は、上位のプランへの変更や、より大きな上限を持つサーバーへの移転を検討します。
上限の種類や超えたときの動きは事業者ごとに違うため、今の契約の上限と、移転先の候補の仕様表を同じ項目で比べることが大切です。
移転先の候補の1つに、レンタルサーバーの「mixhost」があります。
プランごとの上限や料金は変わることがあるため、公式サイトの仕様表で今の契約の上限と比べてから判断してください。
サーバーの見直しを考えたい場合
- 503の時間帯に、CPUやプロセス数が上限に達している
- キャッシュやボット対策をしても、上限に当たり続ける
- 今の契約の上限と、候補の仕様を比べたい
会社のサーバーの場合は、契約の変更や移転の前に、社内の管理者や担当部署に相談してください。
サーバーの種類や、レンタルサーバー・VPS・専用サーバーの違いは、次の記事で詳しく解説しています。
よくある質問とまとめ
Q1. 503エラーとは何ですか?
サーバーが一時的な過負荷やメンテナンスのために、今はリクエストを処理できないことを伝えるHTTPのステータスコードです。
Q2. 503エラーはどれくらいで直りますか?
原因によって数秒から数時間まで幅があり、返事にRetry-Afterや案内の時刻があれば、それが目安になります。
Q3. 503と502の違いは何ですか?
502はプロキシが奥のサーバーから不正な応答を受け取ったことを、503はサーバーが今は一時的に応じられないことを表します。
Q4. 閲覧者側で503を直す方法はありますか?
サーバー側の事情なので直接は直せませんが、別の回線で試す、公式の案内を確かめる、間隔を空けて開き直すことはできます。
Q5. 自分のサイトで503が出たら、まず何を見ればよいですか?
アクセスログで503が始まった時刻と範囲を確かめ、上流の応答やレート制限の記録から、503を返したのがWebサーバーかアプリかを切り分けます。
503エラーは、サーバーが「今は一時的に引き受けられない」と答えている状態で、原因は過負荷、上限、メンテナンス、奥のサーバーの停止、レート制限などさまざまです。
次の図は、この記事の要点をまとめたものです。
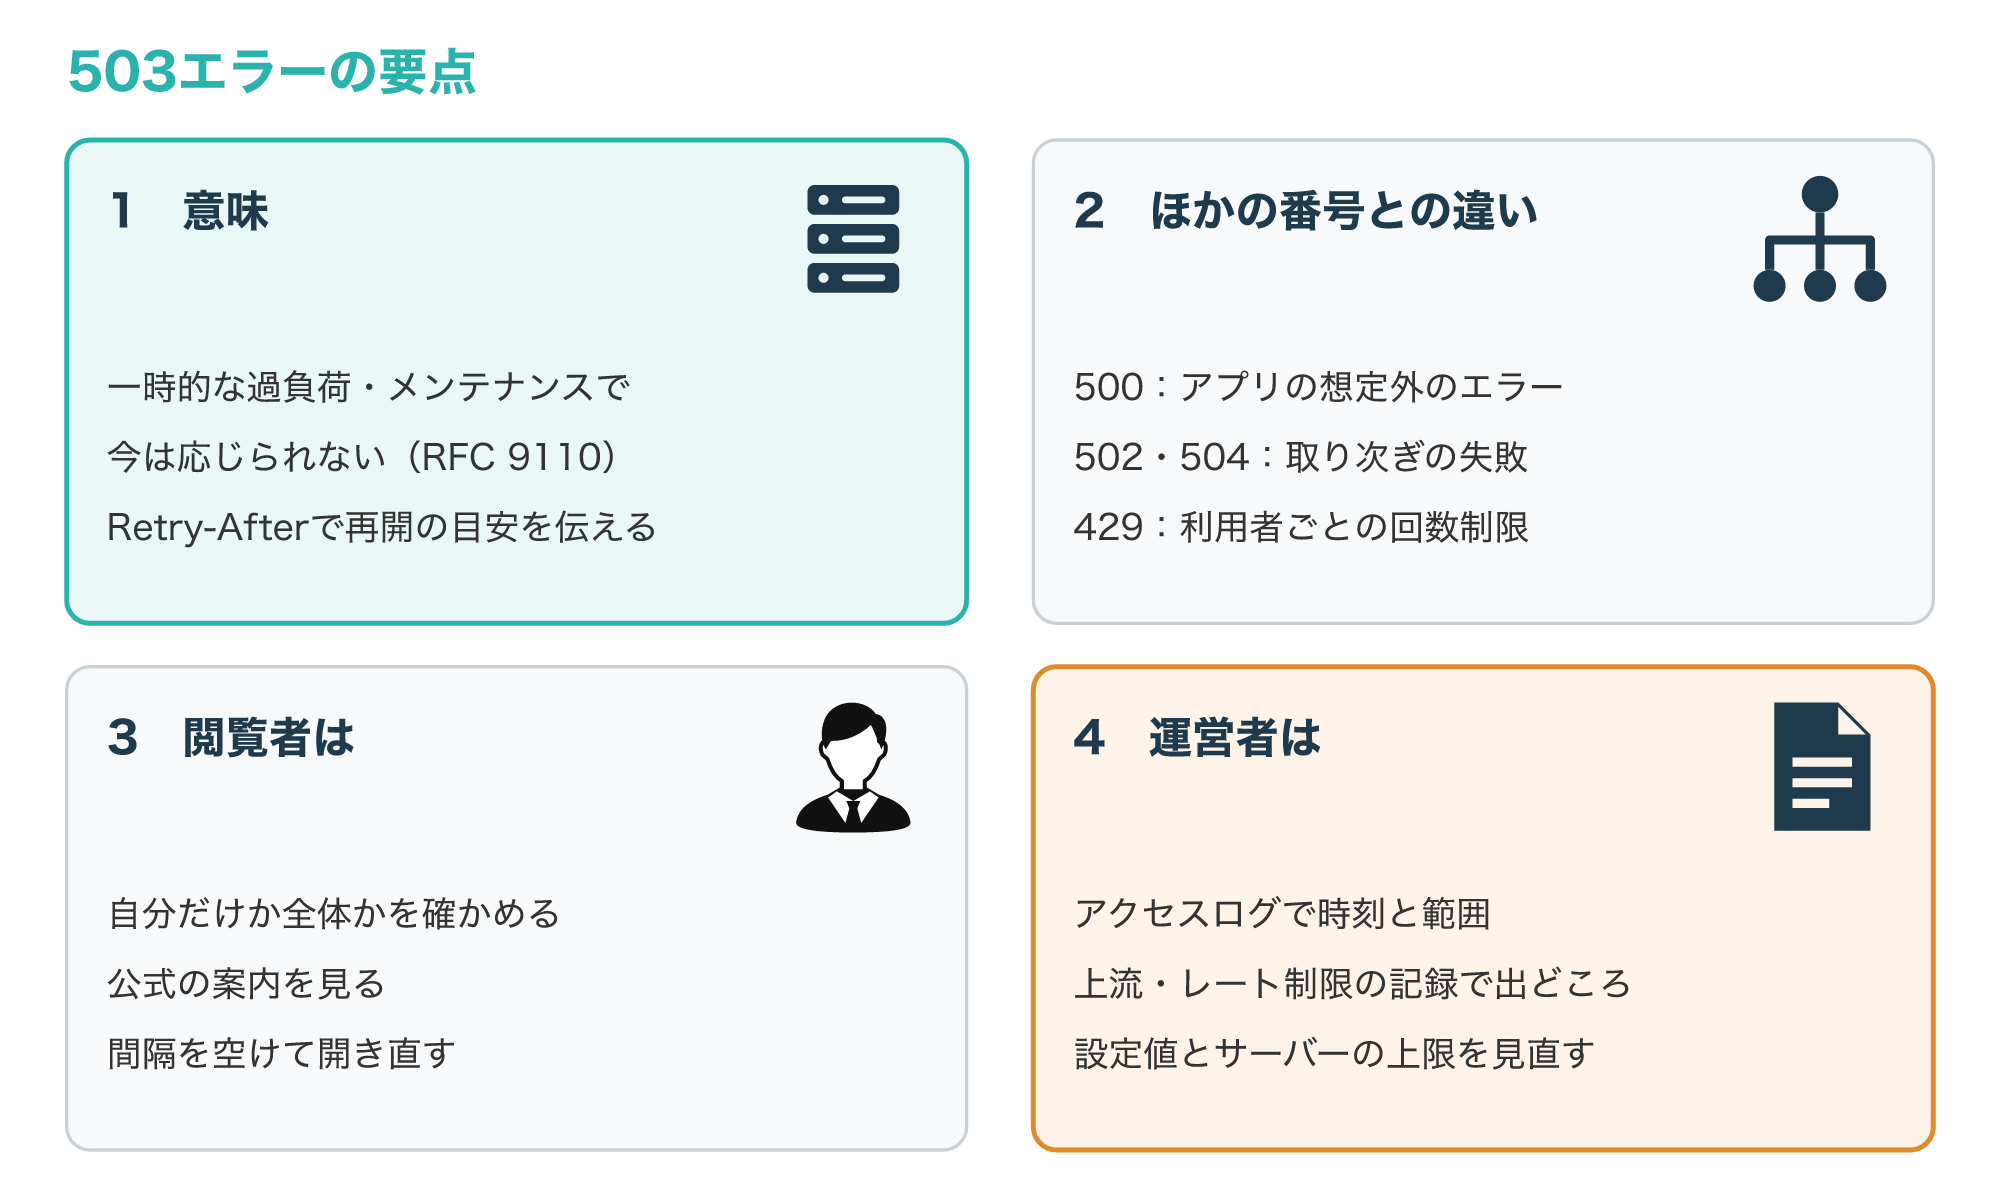
閲覧者は、自分だけか全体かを確かめたうえで、案内の時刻まで間隔を空けて開き直しましょう。
運営者は、アクセスログで範囲をつかみ、上流とレート制限の記録で出どころを特定してから、設定値とサーバーの上限を見直します。
まずは今日、自分のサイトの記録形式に上流のステータスコードが含まれているかを確かめるところから始めてください。