MIMEとは?ヘッダー・Base64・MIMEタイプの仕組みを図解
MIME(Multipurpose Internet Mail Extensions)とは、英数字のテキストが前提だったメールで、日本語や画像・PDFの添付、複数のパートを送れるようにした拡張仕様です。
この記事では、MIMEのヘッダー、multipartとboundary、Base64と日本語の件名、WebのMIMEタイプとnosniffを、実際のメールヘッダーとHTTPレスポンスの例で図解します。

この記事は以下のような人におすすめ!
- MIMEのヘッダーの意味を知りたい人
- 文字化けや添付の不具合を調べたい人
- MIMEタイプとnosniffを設定したい人
MIMEとは:メールで日本語や添付ファイルを送るための拡張
1-1. MIMEはRFC 822のメールに4つの機能を加えた
インターネットのメールの書式は1982年に公開されたRFC 822で定められ、本文はUS-ASCIIのテキストとして扱われていました。
RFC 822は文字のメッセージのための仕様で、音声や画像のような文字以外のデータや、日本語のようにUS-ASCIIより多くの文字を使う言語は想定していませんでした。
また、当時のSMTPのメールは、1行がCRLF(行末の改行)を含めて1000文字以内の、7bitのUS-ASCIIに限られていました。
MIMEは、この書式を既存のメールとの互換性を保ったまま拡張し、4つのことをできるようにした仕様です。
次の図は、RFC 822のメールの制約と、MIMEで加わった4つの機能を、実際のヘッダーの書き方とあわせて示したものです。
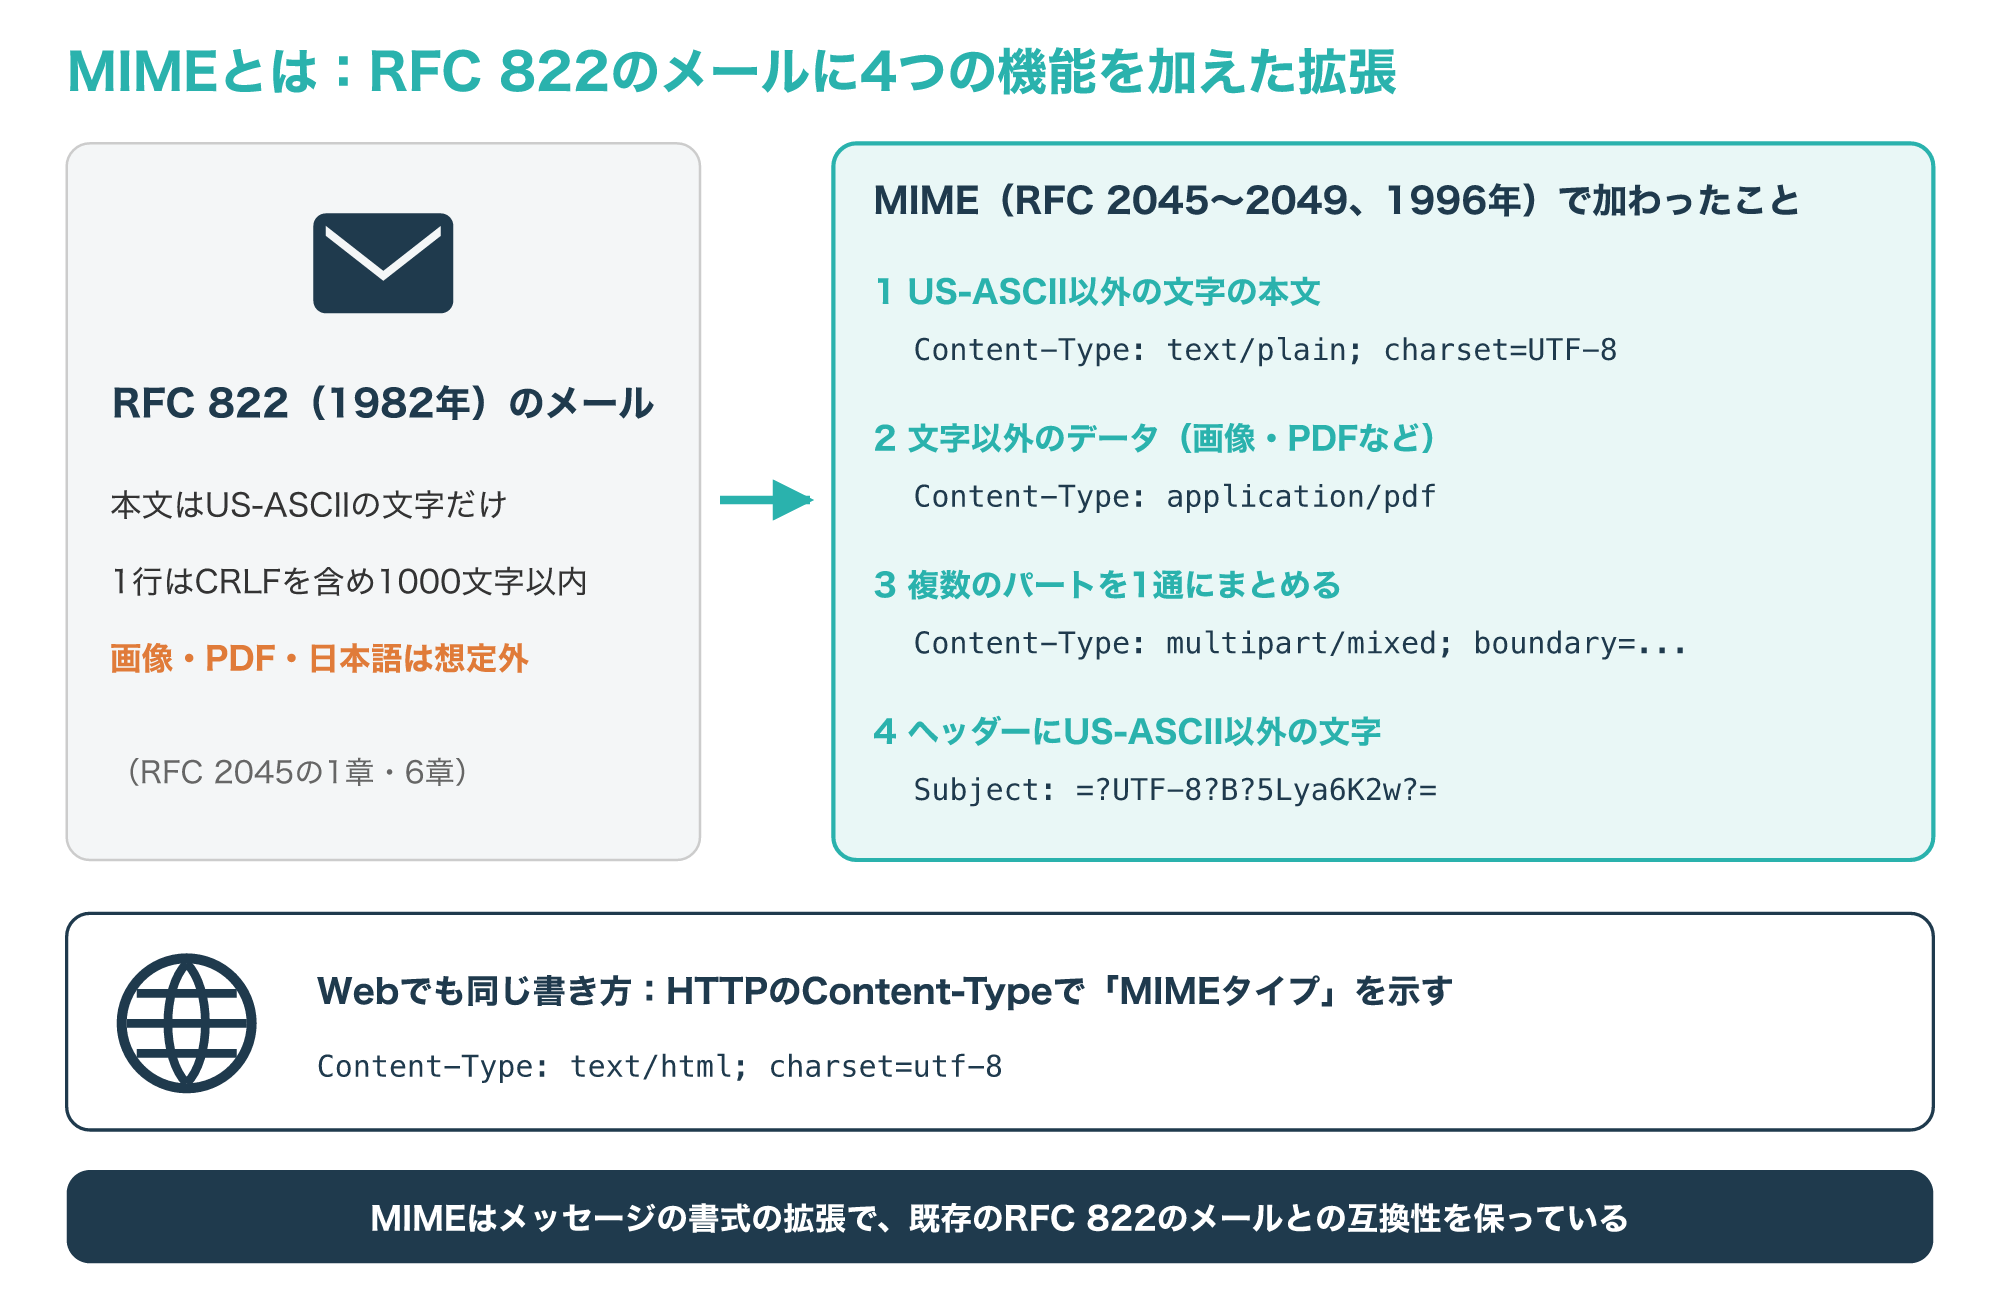
1つ目はUS-ASCII以外の文字セットで書いた本文で、2つ目は画像や音声などの文字以外の形式の本文です。
3つ目は1通に複数のパートを入れる本文で、4つ目はヘッダーにUS-ASCII以外の文字を書く方法です。
MIMEが決めるのはメッセージの書式で、メールを運ぶSMTPの仕組みそのものはそのまま使われます(参考1)。
SMTPの仕組みと送信の設定は、次の記事で解説しています。
1-2. RFC 2045〜2049の5部構成と、Webの「MIMEタイプ」
MIMEの中心となる仕様は、1996年11月に公開されたRFC 2045〜2049の5つの文書です。
RFC 2045はヘッダーと本文の変換方式、RFC 2046はメディアタイプとmultipart、RFC 2047はヘッダーでのUS-ASCII以外の文字を定めています。
RFC 2048は登録の手続きを、RFC 2049は適合の条件とメッセージの例を扱っています。
これらはRFC 1521・1522・1590を改訂したもので、さらにその元になったのがRFC 1341と1342です。
RFC 2045は、Content-Typeの値を「メディアタイプ」と呼び、大分類のtypeと具体的な形式を表すsubtypeの組み合わせで書くと定めています。
この書き方はメール以外にも使われ、WebのHTTPでも、Content-Typeヘッダーでメディアタイプを示します。
MDNによると、メディアタイプは以前「MIMEタイプ」と呼ばれていたもので、現在の定義はRFC 6838にあり、公式の一覧はIANAが管理しています。
そのため、「MIME」はメールの拡張仕様の全体を、「MIMEタイプ」はその中のContent-Typeの値を指すと考えると、両者を混同しにくくなります(参考1・参考4・参考6)。
MIMEはメールの書式の拡張で、WebのContent-Typeで使う「MIMEタイプ(メディアタイプ)」はその書き方を受け継いだものです。
MIMEのヘッダー:MIME-Version・Content-Type・Content-Transfer-Encoding
2-1. MIME-Versionと実際のメールヘッダー
MIMEのメールには、ふだんメールソフトが表示しないヘッダーの中に、MIMEのためのヘッダーがいくつか入っています。
次の図は、日本語の件名と本文を持つメールのヘッダーを、MIMEのヘッダーに注目して示したものです。
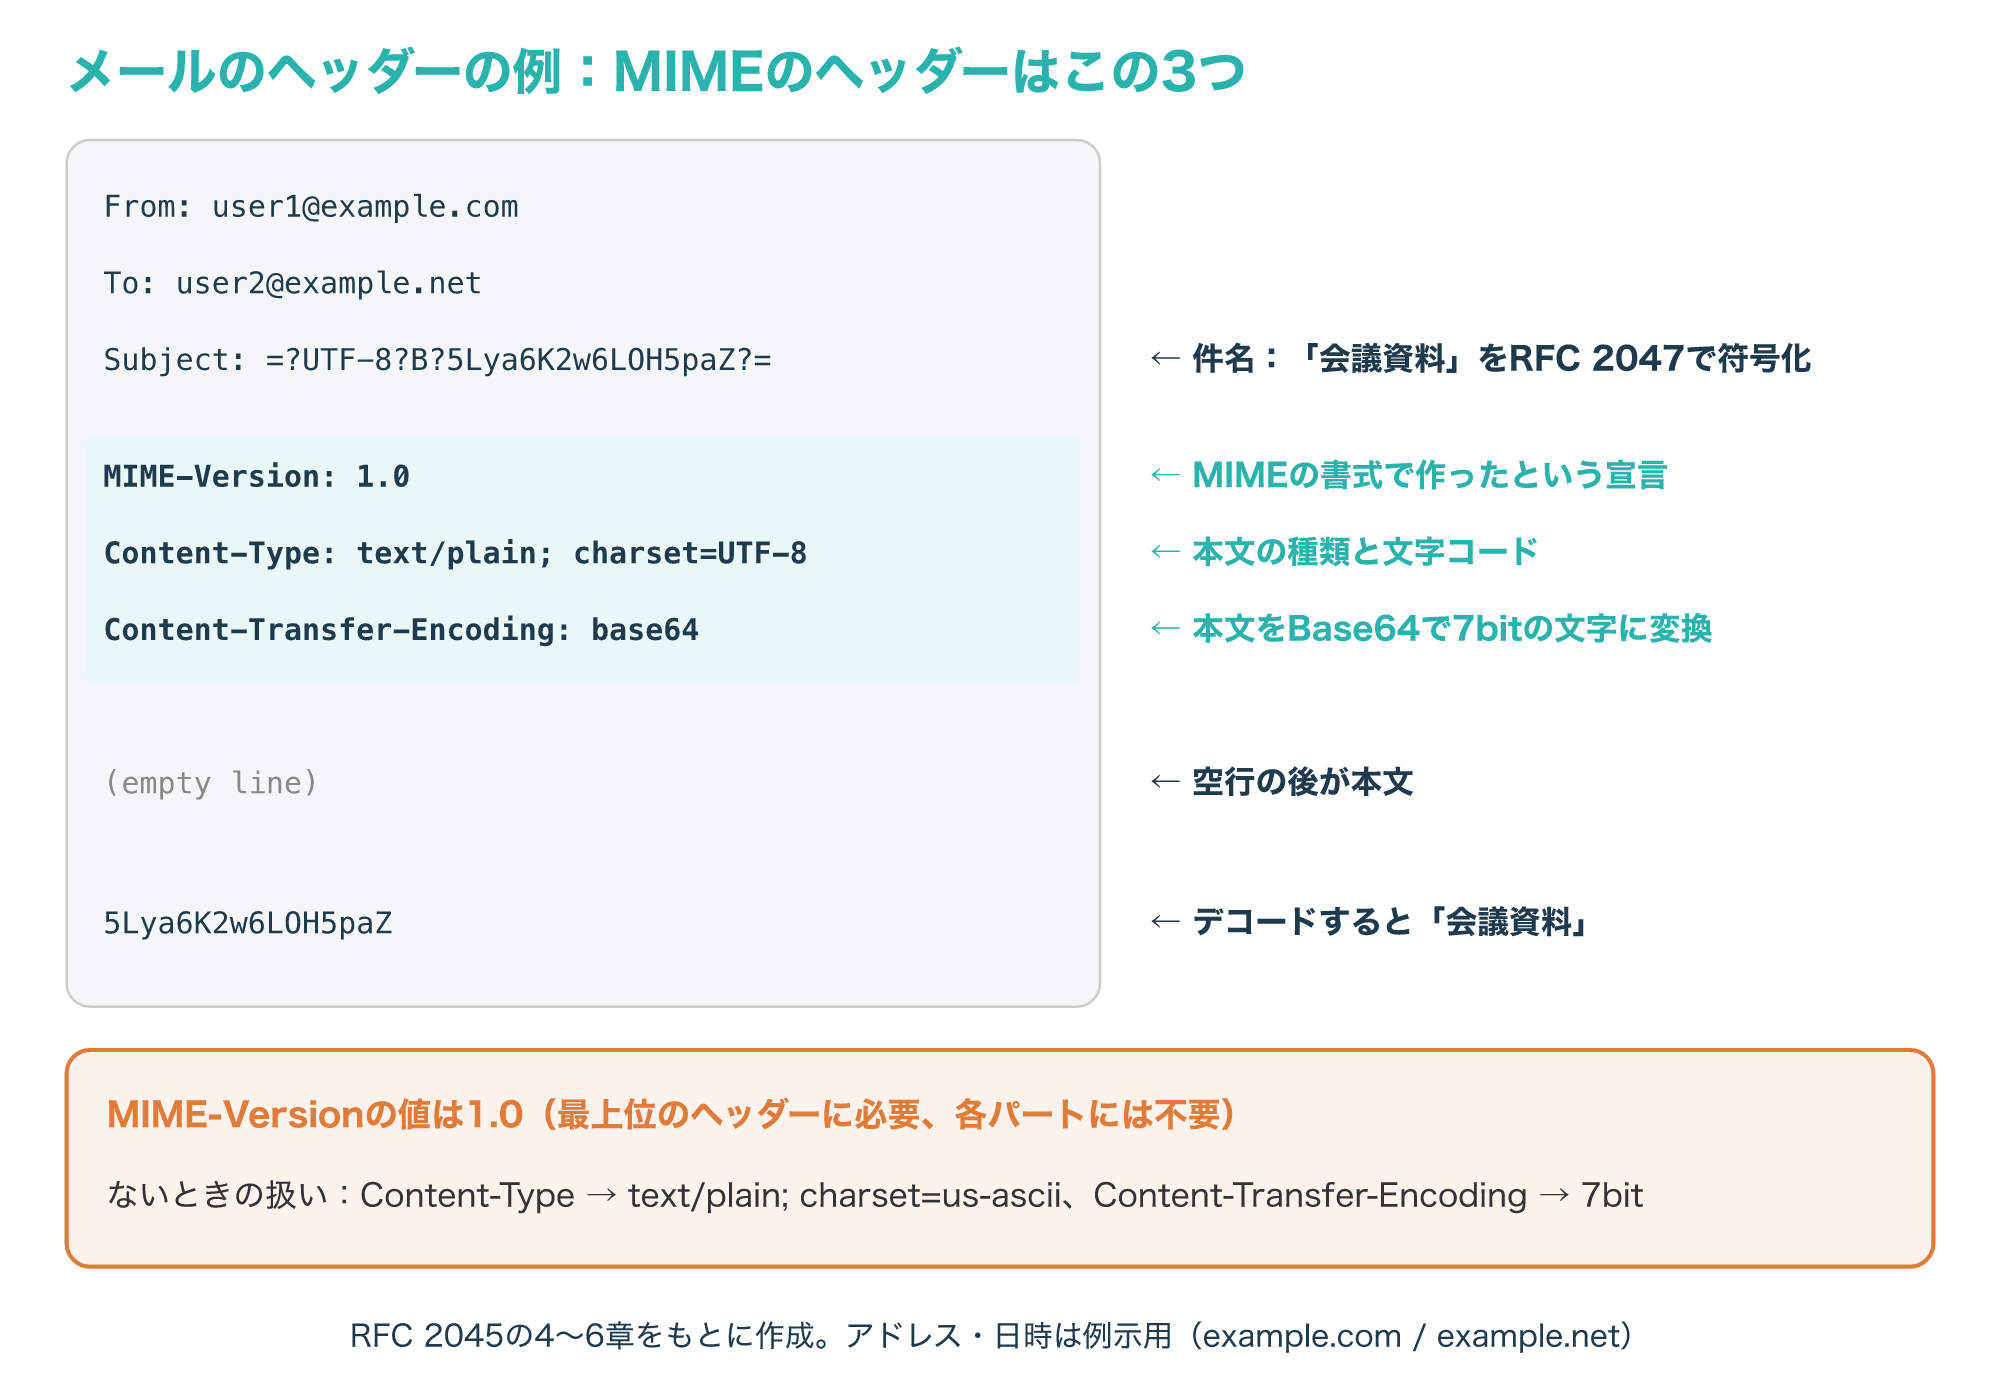
MIME-Versionは、そのメッセージがMIMEの仕様に沿って作られたことを示すヘッダーで、RFC 2045は値を「1.0」と書くよう定めています。
MIME-Versionはメッセージの最上位のヘッダーに必要で、multipartの中の各パートには必要ありません。
「MIME-Version: 1.0 (produced by MetaSend Vx.x)」のように、かっこで囲んだコメントが付いていても、値は1.0と同じに扱われます。
MIME-Versionがないメールは受信側のソフトが独自の決まりで解釈してよいとされ、中身がUS-ASCIIのテキストだとは言い切れません。
図の例では、Content-Typeで本文がUTF-8のテキストであることを、Content-Transfer-Encodingで本文がBase64に変換されていることを示し、空行の後に本文が続きます(参考1)。
2-2. Content-Typeは「type/subtype; パラメーター」で書く
Content-Typeは、本文のデータが何かを受信側に伝え、表示や処理の方法を選べるようにするヘッダーです。
値は「type/subtype」の形で、typeが画像やテキストなどの大分類を、subtypeがJPEGやHTMLなどの具体的な形式を表します。
次の図は、Content-Typeの書き方と、RFC 2046で定められた7つのtypeを示したものです。
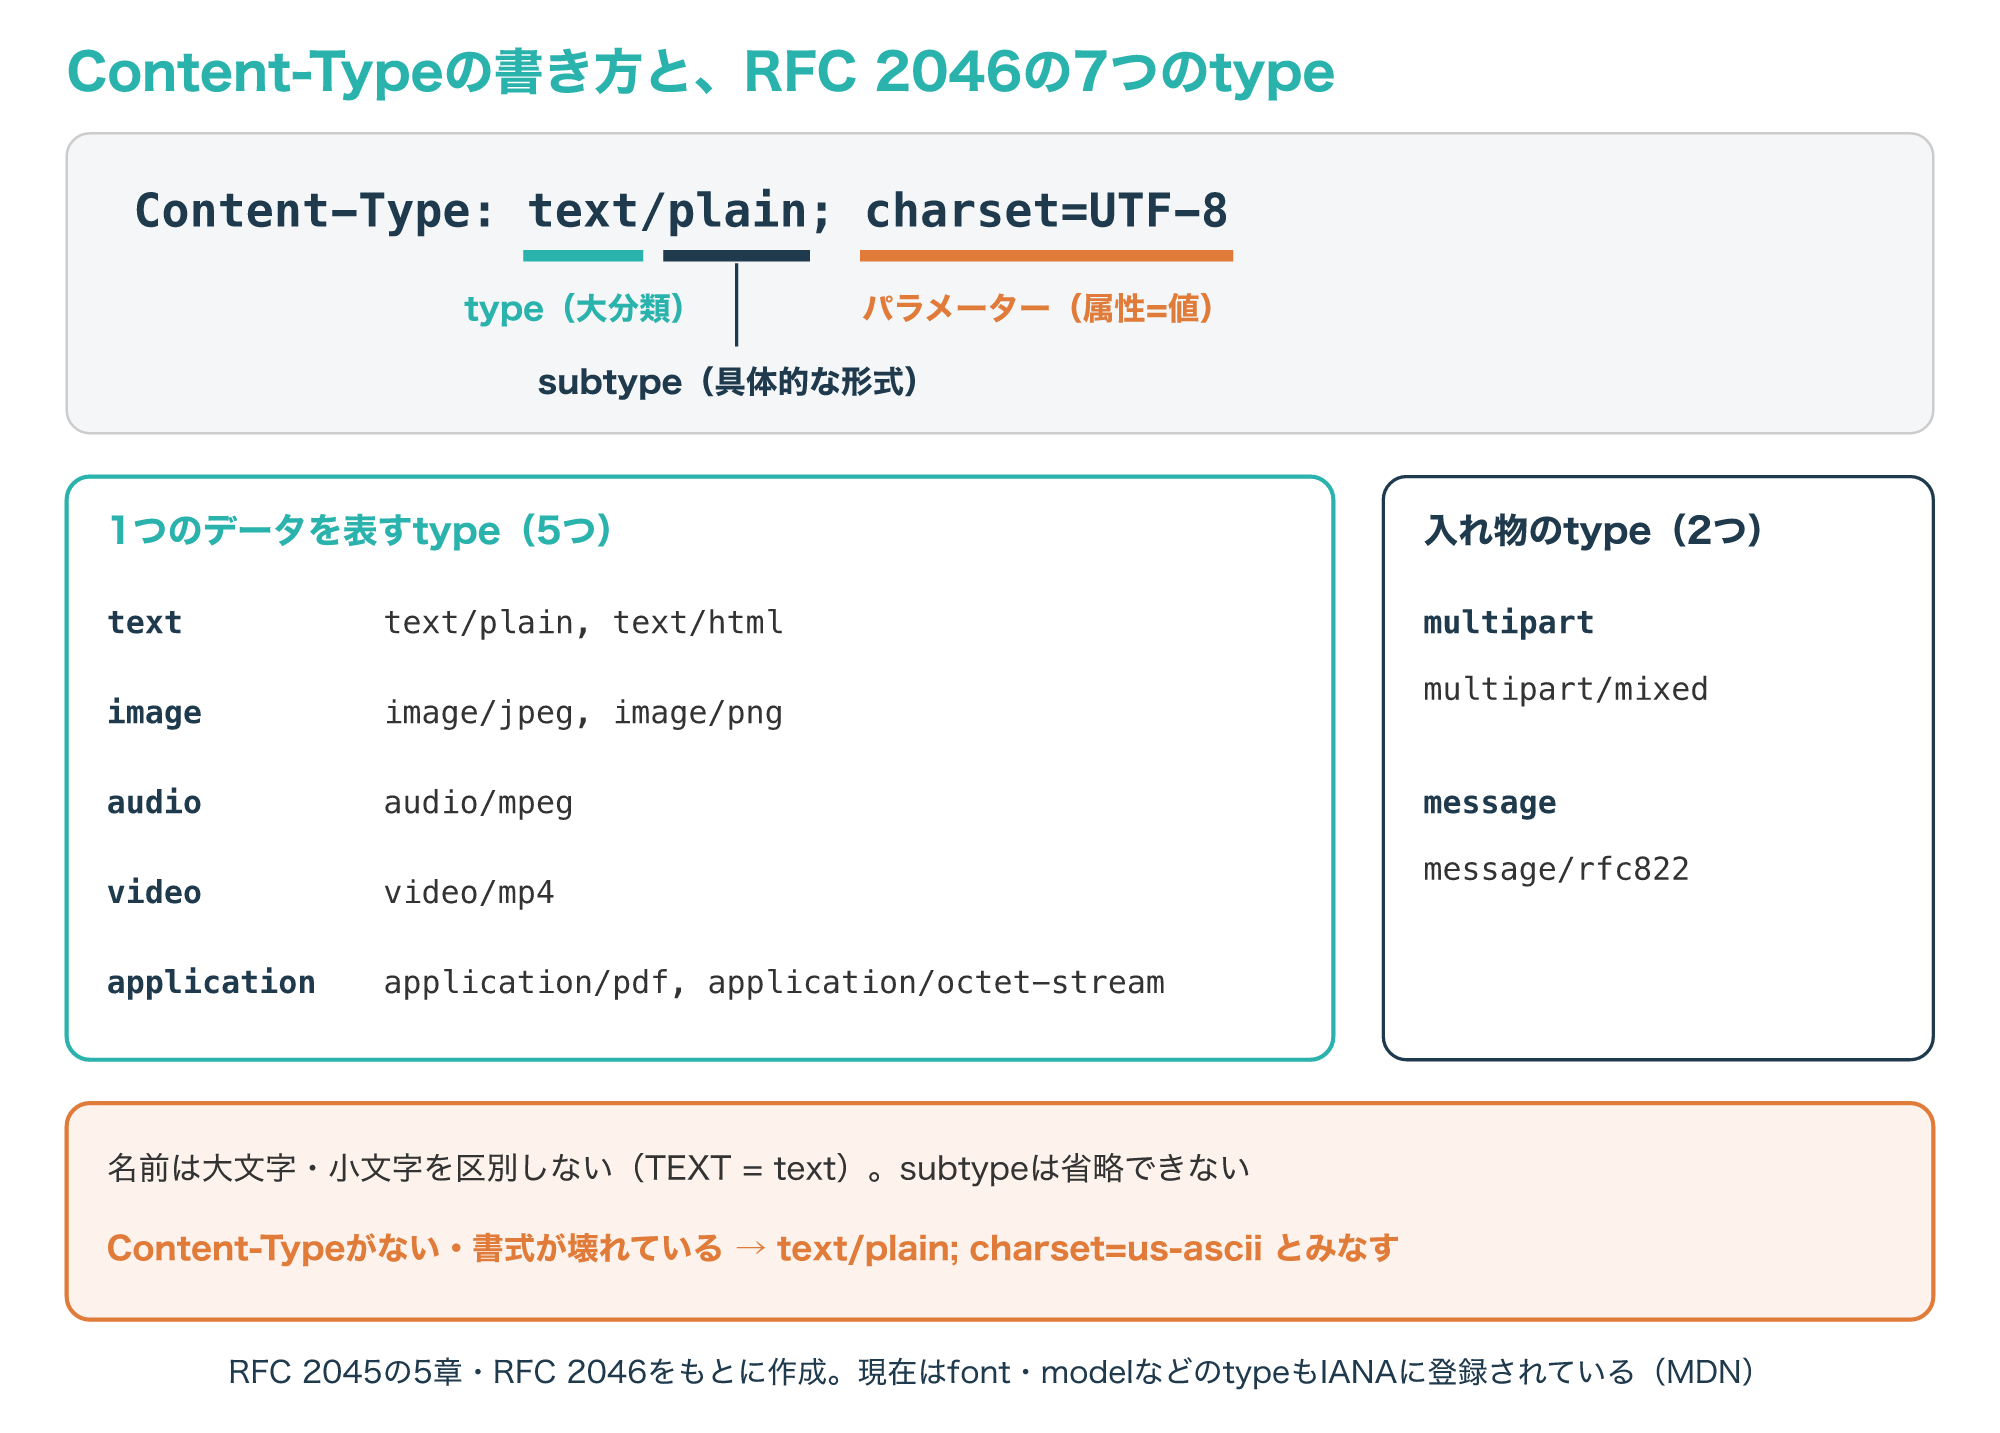
subtypeは省略できず、typeとsubtype、パラメーターの名前は大文字と小文字を区別しません。
セミコロンの後のパラメーターは「属性=値」の形で、textのcharset(文字コード)や、multipartで必須のboundaryがその例です。
7つのtypeのうち、text・image・audio・video・applicationの5つは1つのデータを表し、multipartとmessageの2つは中にほかのデータを含む入れ物です。
RFC 2046はapplication/octet-streamを任意のバイナリデータを表す値とし、受け取ったソフトはファイルとして保存するよう利用者に提案するのがよいとしています。
MDNによると、現在はfont(フォント)やmodel(3Dのモデル)などのtypeもIANAに登録されています。
Content-Typeがない場合や書式が正しくない場合、RFC 2045ではUS-ASCIIのプレーンテキスト(text/plain; charset=us-ascii)とみなします(参考1・参考2・参考6)。
2-3. Content-Transfer-Encodingは本文の変換方式を示す
SMTPのメールは1行1000文字以内の7bitのUS-ASCIIに限られるため、画像や8bitの文字をそのまま入れると、途中で壊れるおそれがあります。
そこでRFC 2045は、本文を7bitの短い行に変換する方式と、その方式を示すContent-Transfer-Encodingヘッダーを定めました。
次の図は、Content-Transfer-Encodingの5つの値と、それぞれの意味を示したものです。
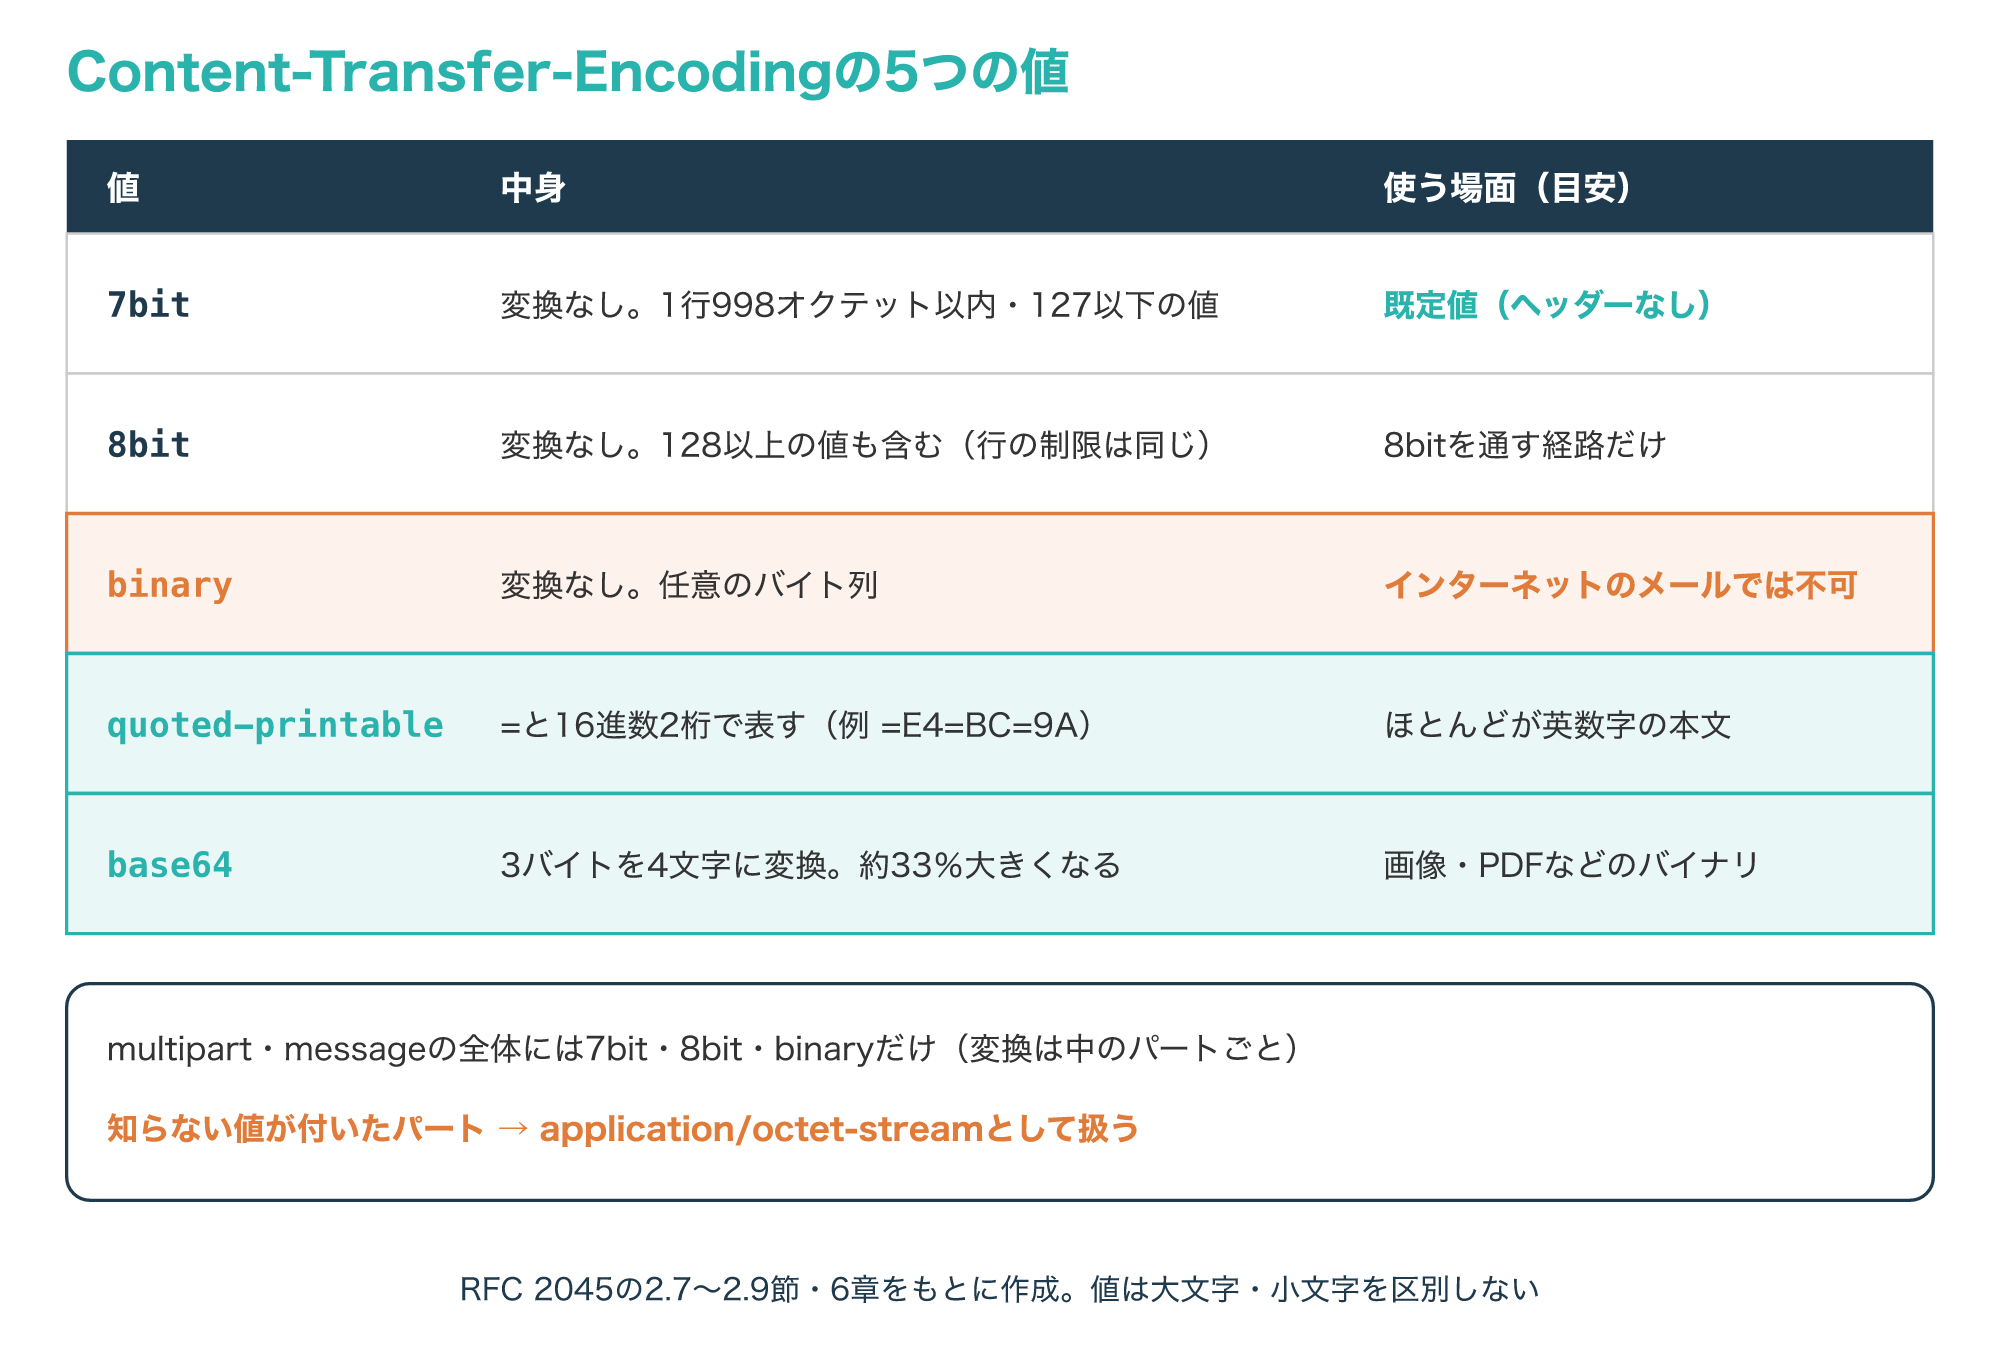
7bit・8bit・binaryの3つは「変換していない」ことを示す値で、本文がどの範囲のデータかを伝えるだけです。
7bitは、1行が998オクテット以内で、127を超える値とNUL(値0)を含まないデータを指し、ヘッダーがないときの既定値でもあります。
オクテットは8ビット(1バイト)のまとまりのことで、メールのRFCでは文字数ではなくこの単位で長さを数えます。
998は行末のCRLF(2オクテット)を除いた数で、1-1で触れた「CRLFを含めて1000文字以内」と同じ制限です。
quoted-printableとbase64はどんなデータも7bitの範囲に変換する方式で、前者はおおむね読める形を残す方式、後者は密度の高い方式とされています。
RFC 2045が書かれた時点では、インターネットのメールで変換していないバイナリを運ぶ標準の方法はなく、binaryの値はインターネットのメールでは使えないとされています。
multipartとmessageの全体には7bit・8bit・binaryしか付けられず、変換は中のパートごとに行います。
知らない値のContent-Transfer-Encodingが付いたパートは、Content-Typeの値にかかわらずapplication/octet-streamとして扱われます(参考1)。
multipartとboundary:添付ファイルつきメールの構造
3-1. boundaryで区切り、最後は「–」で閉じる
本文と添付ファイルのように複数のパートを1通に入れるときは、Content-Typeをmultipartにして、boundaryというパラメーターで区切りの文字列を宣言します。
次の図は、本文1つとPDFの添付ファイル1つを持つメールのソースを、区切りの行に注目して示したものです。
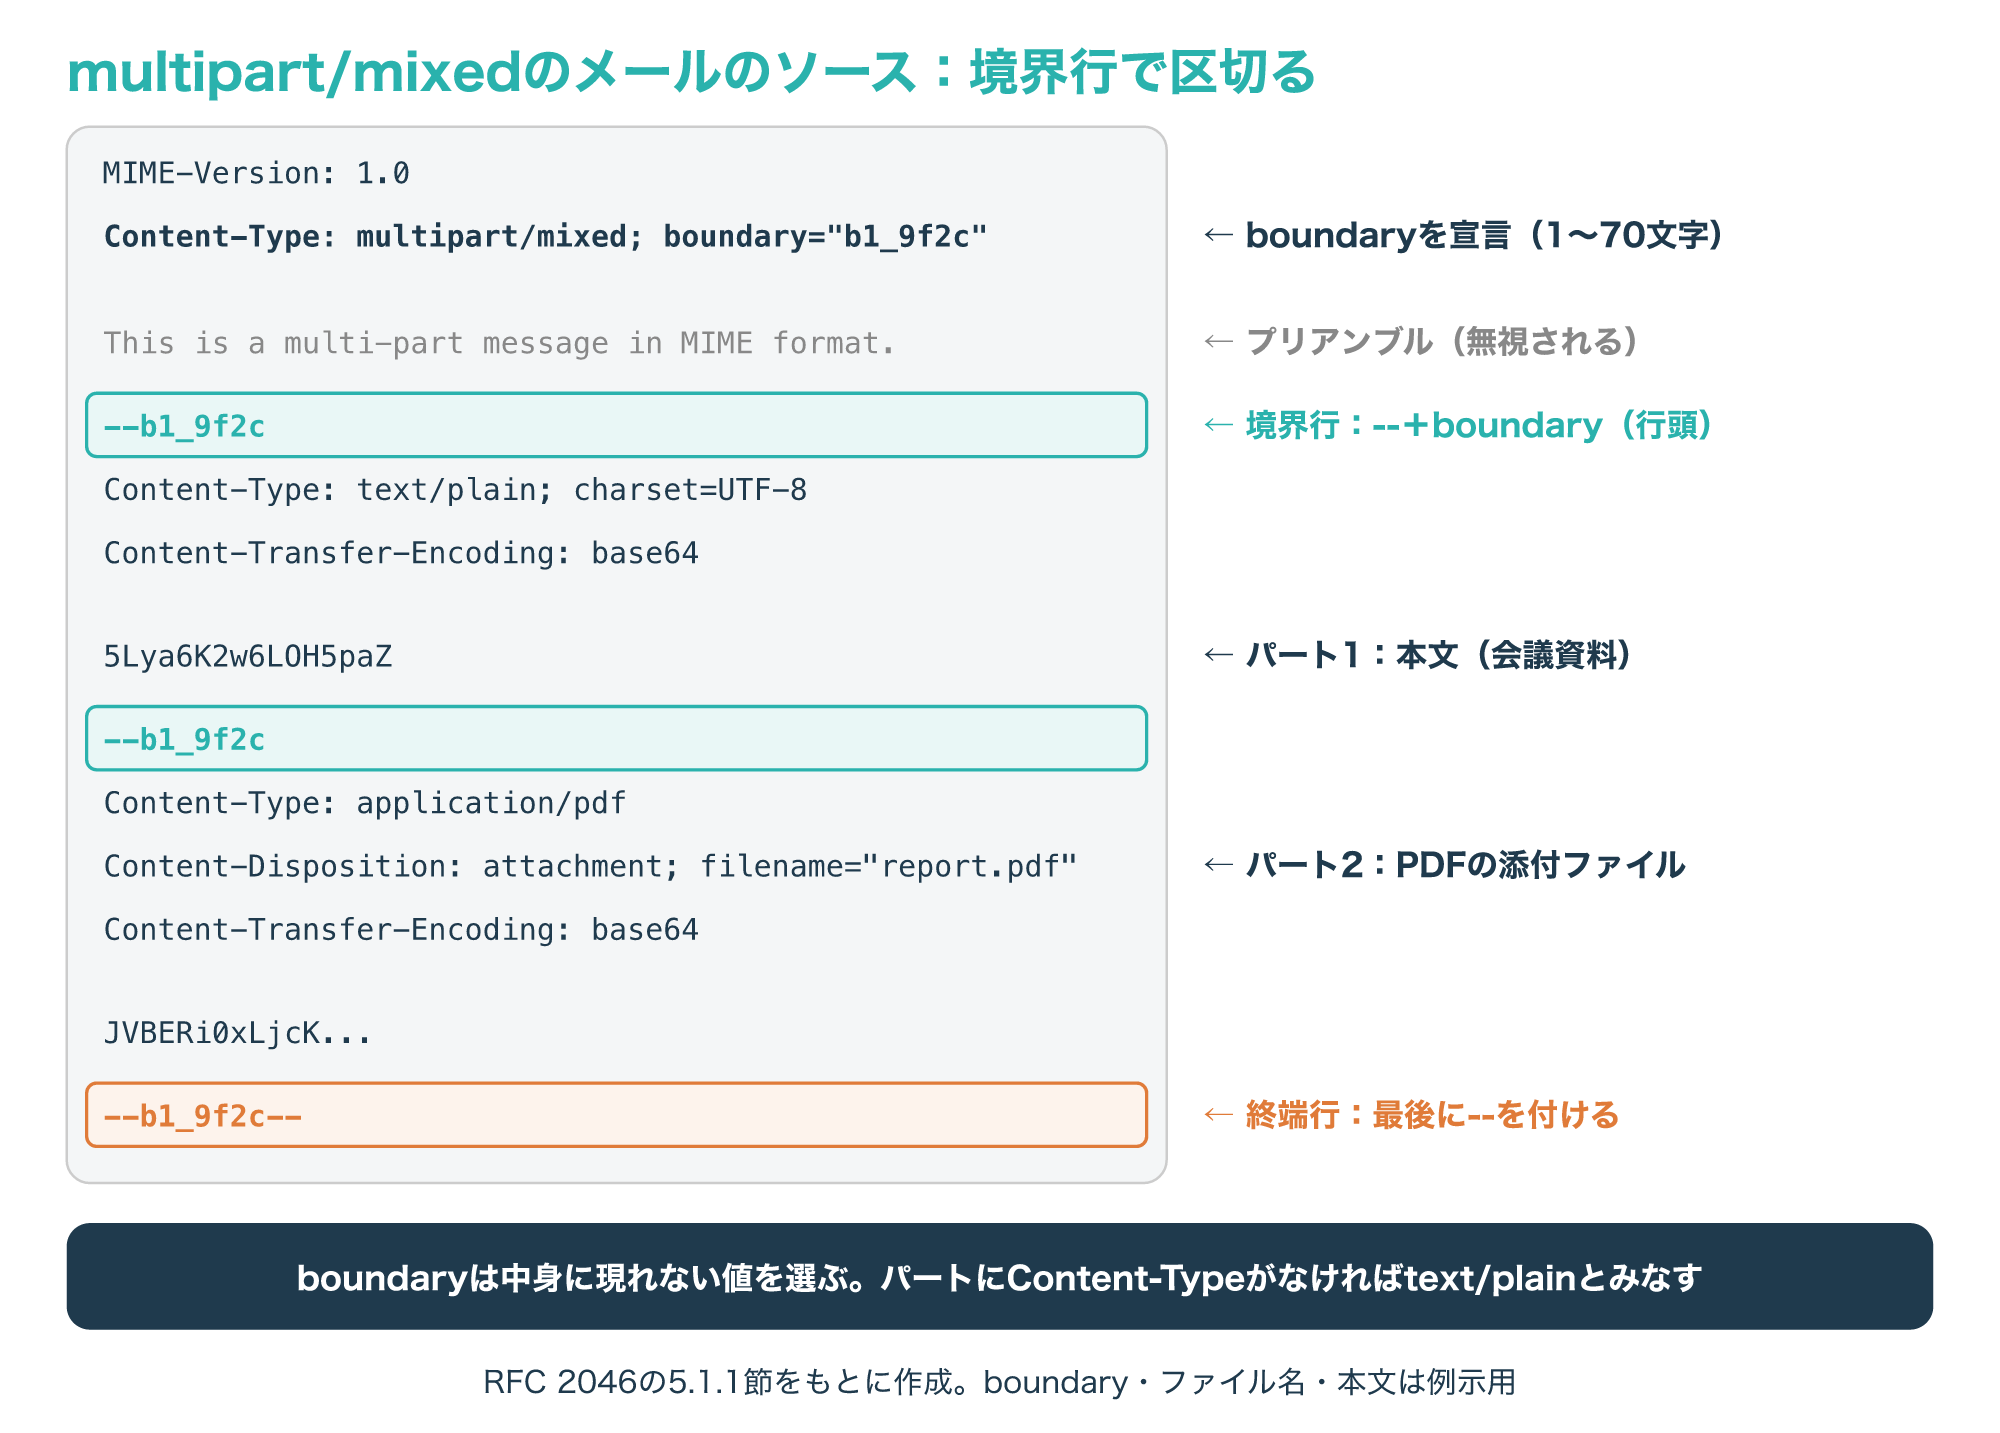
各パートの前には、2つのハイフン「–」の後にboundaryの値を続けた境界行が、行の先頭に置かれます。
最後のパートの後には、境界行の末尾にさらに「–」を付けた終端行が置かれ、これ以上パートがないことを示します。
boundaryの値は1〜70文字で、パートの中身に同じ文字列が現れてはいけないため、メールソフトは中身と重ならない値を選ぶ必要があります。
コロンなどの記号を含むboundaryは、ダブルクォートで囲まないとContent-Typeの書式として正しくありません。
最初の境界行より前のプリアンブルと終端行より後のエピローグは、MIMEに対応したソフトでは無視されます。
各パートはヘッダーと空行と中身からなり、パートにContent-Typeがない場合はtext/plainとみなされます。
なお、RFC 2046では、添付ファイルの名前はContent-Typeのパラメーターではなく、別に定めるContent-Dispositionヘッダーで示す方針とされています(参考2)。
3-2. multipart/mixedとmultipart/alternativeの違い
multipartのsubtypeのうちよく使われるのが、独立したパートを順番に並べるmixedと、同じ内容を別の形式で入れるalternativeです。
次の図は、HTMLメールに添付ファイルを付けたときの、multipartの入れ子の例を示したものです。
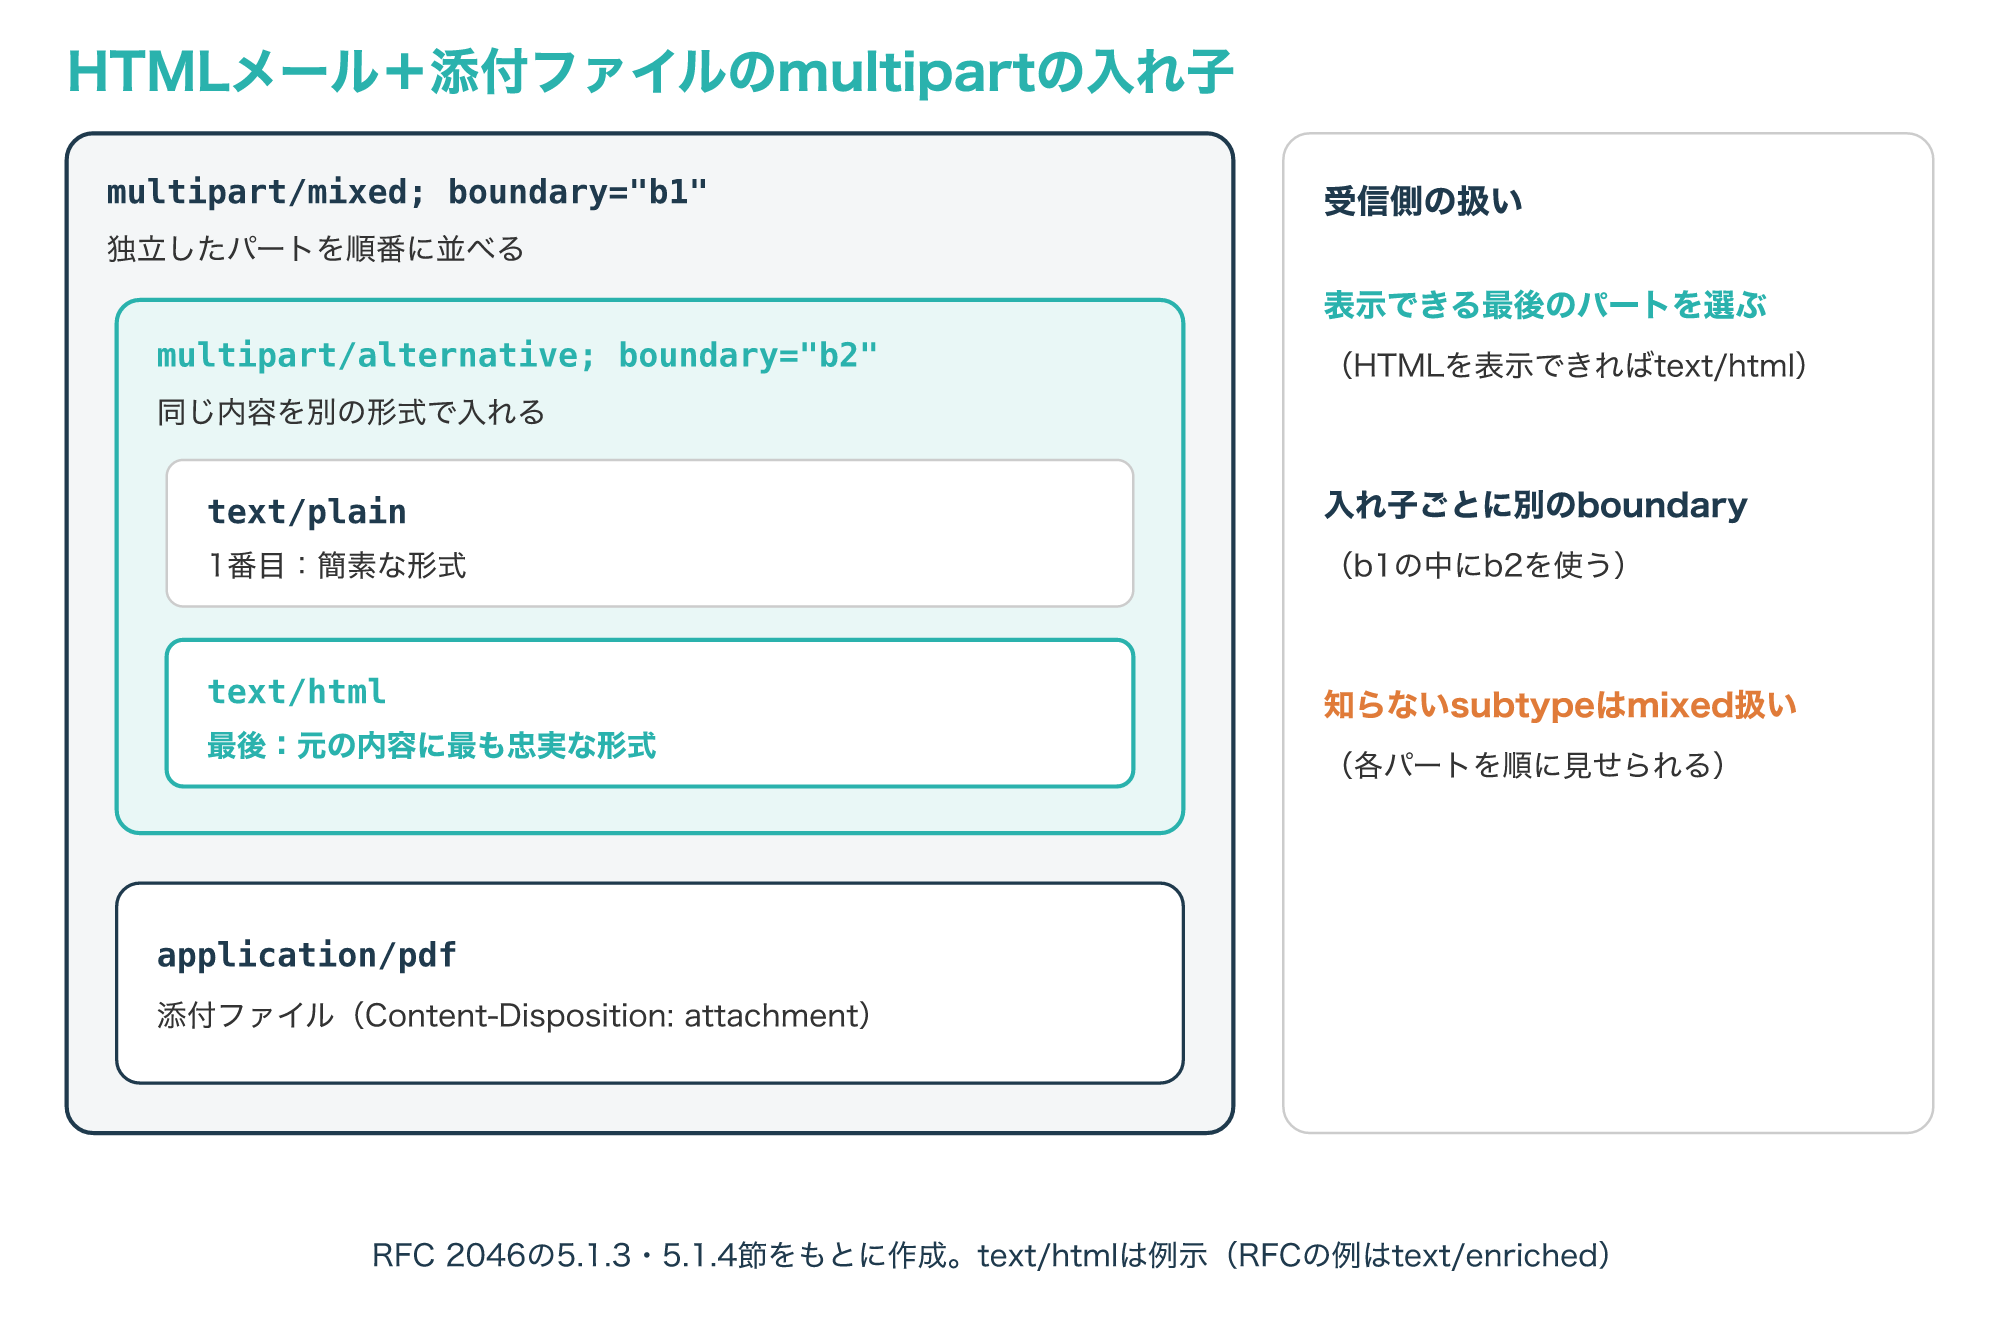
multipart/alternativeでは、パートを簡素な形式から元の内容に忠実な形式の順に並べ、受信側は表示できる最後のパートを選んで表示します。
そのため、プレーンテキストを先に、装飾のある形式を後に置くのが基本の並べ方です。
multipartの中にmultipartを入れることもでき、その場合は入れ子ごとに別のboundaryを使う必要があります。
受信側のソフトは知らないsubtypeのmultipartをmixedとして扱うと定められているため、少なくとも各パートを順に見せることはできます(参考2)。
受信したメールのこうした構造は、POPやIMAPでメールを取り出したメールソフトが解釈し、本文と添付ファイルに分けて表示します。
メールを受け取るPOPとIMAPの仕組みは、次の記事で解説しています。
Base64とquoted-printable、日本語の件名
4-1. Base64は3バイトを4文字に、quoted-printableは「=」と16進数で表す
Base64は、データを3バイト(24ビット)ずつ区切って6ビットずつ4つに分け、それぞれを64種類の文字の1つに置き換える方式です。
使う文字はA〜Z、a〜z、0〜9、+、/の64種類で、データの最後が3バイトに満たないときは、=を埋め草として付けます。
次の図は、Base64とquoted-printableで、実際の値がどのように変換されるかを示したものです。
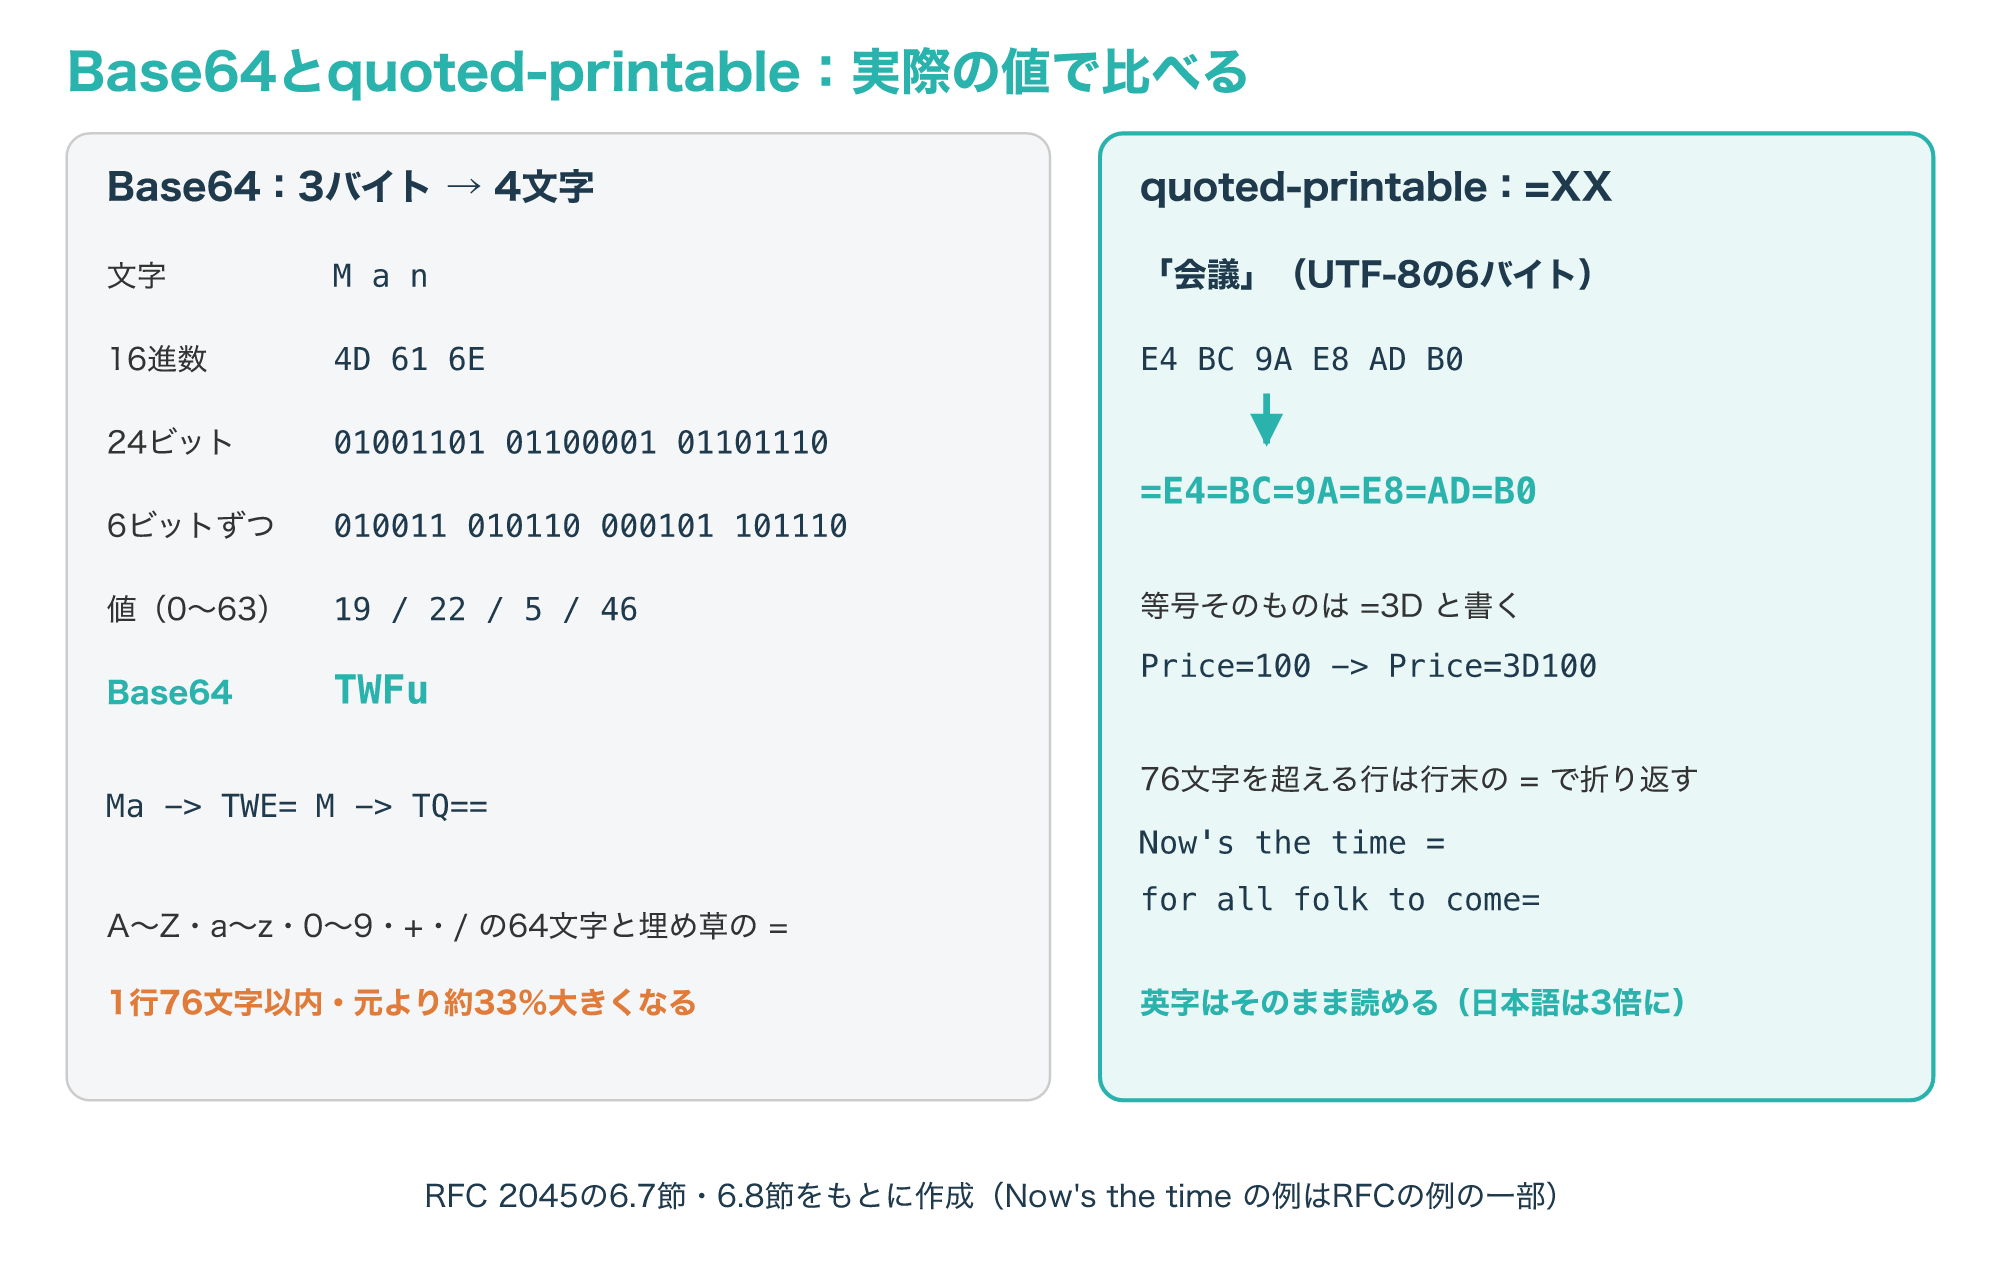
図の左では、英字の「Man」の3バイトが「TWFu」の4文字になり、2バイトの「Ma」は「TWE=」に、1バイトの「M」は「TQ==」になっています。
Base64の64文字は、SMTPで特別な意味を持つピリオドや、boundaryで使うハイフンを含まないように選ばれています。
変換後のデータは元のデータより約33%大きくなり、1行は76文字以内に収めます。
quoted-printableは、印字できる英数字はそのまま残し、それ以外のバイトを「=」と大文字の16進数2桁で表す方式です。
例えば、UTF-8の「会議」の6バイトは「=E4=BC=9A=E8=AD=B0」となり、等号そのものは「=3D」と書きます。
quoted-printableでも1行は76文字以内で、長い行は行末に「=」を置くソフト改行で折り返し、受信側で元の1行に戻します。
英数字が多い本文ならquoted-printableの方が人に読みやすく、日本語のようにほとんどが英数字以外のデータなら、1バイトが3文字になるquoted-printableよりBase64の方が短くなります(参考1)。
4-2. 日本語の件名はRFC 2047のencoded-wordで書く
Content-Transfer-Encodingは本文に付ける変換方式なので、件名や差出人の表示名のようなヘッダーの文字には使えません。
ヘッダーにUS-ASCII以外の文字を書く方法を定めたのがRFC 2047で、その書き方をencoded-wordと呼びます。
次の図は、件名の「会議資料」をencoded-wordで書いたときの、各部分の意味を示したものです。
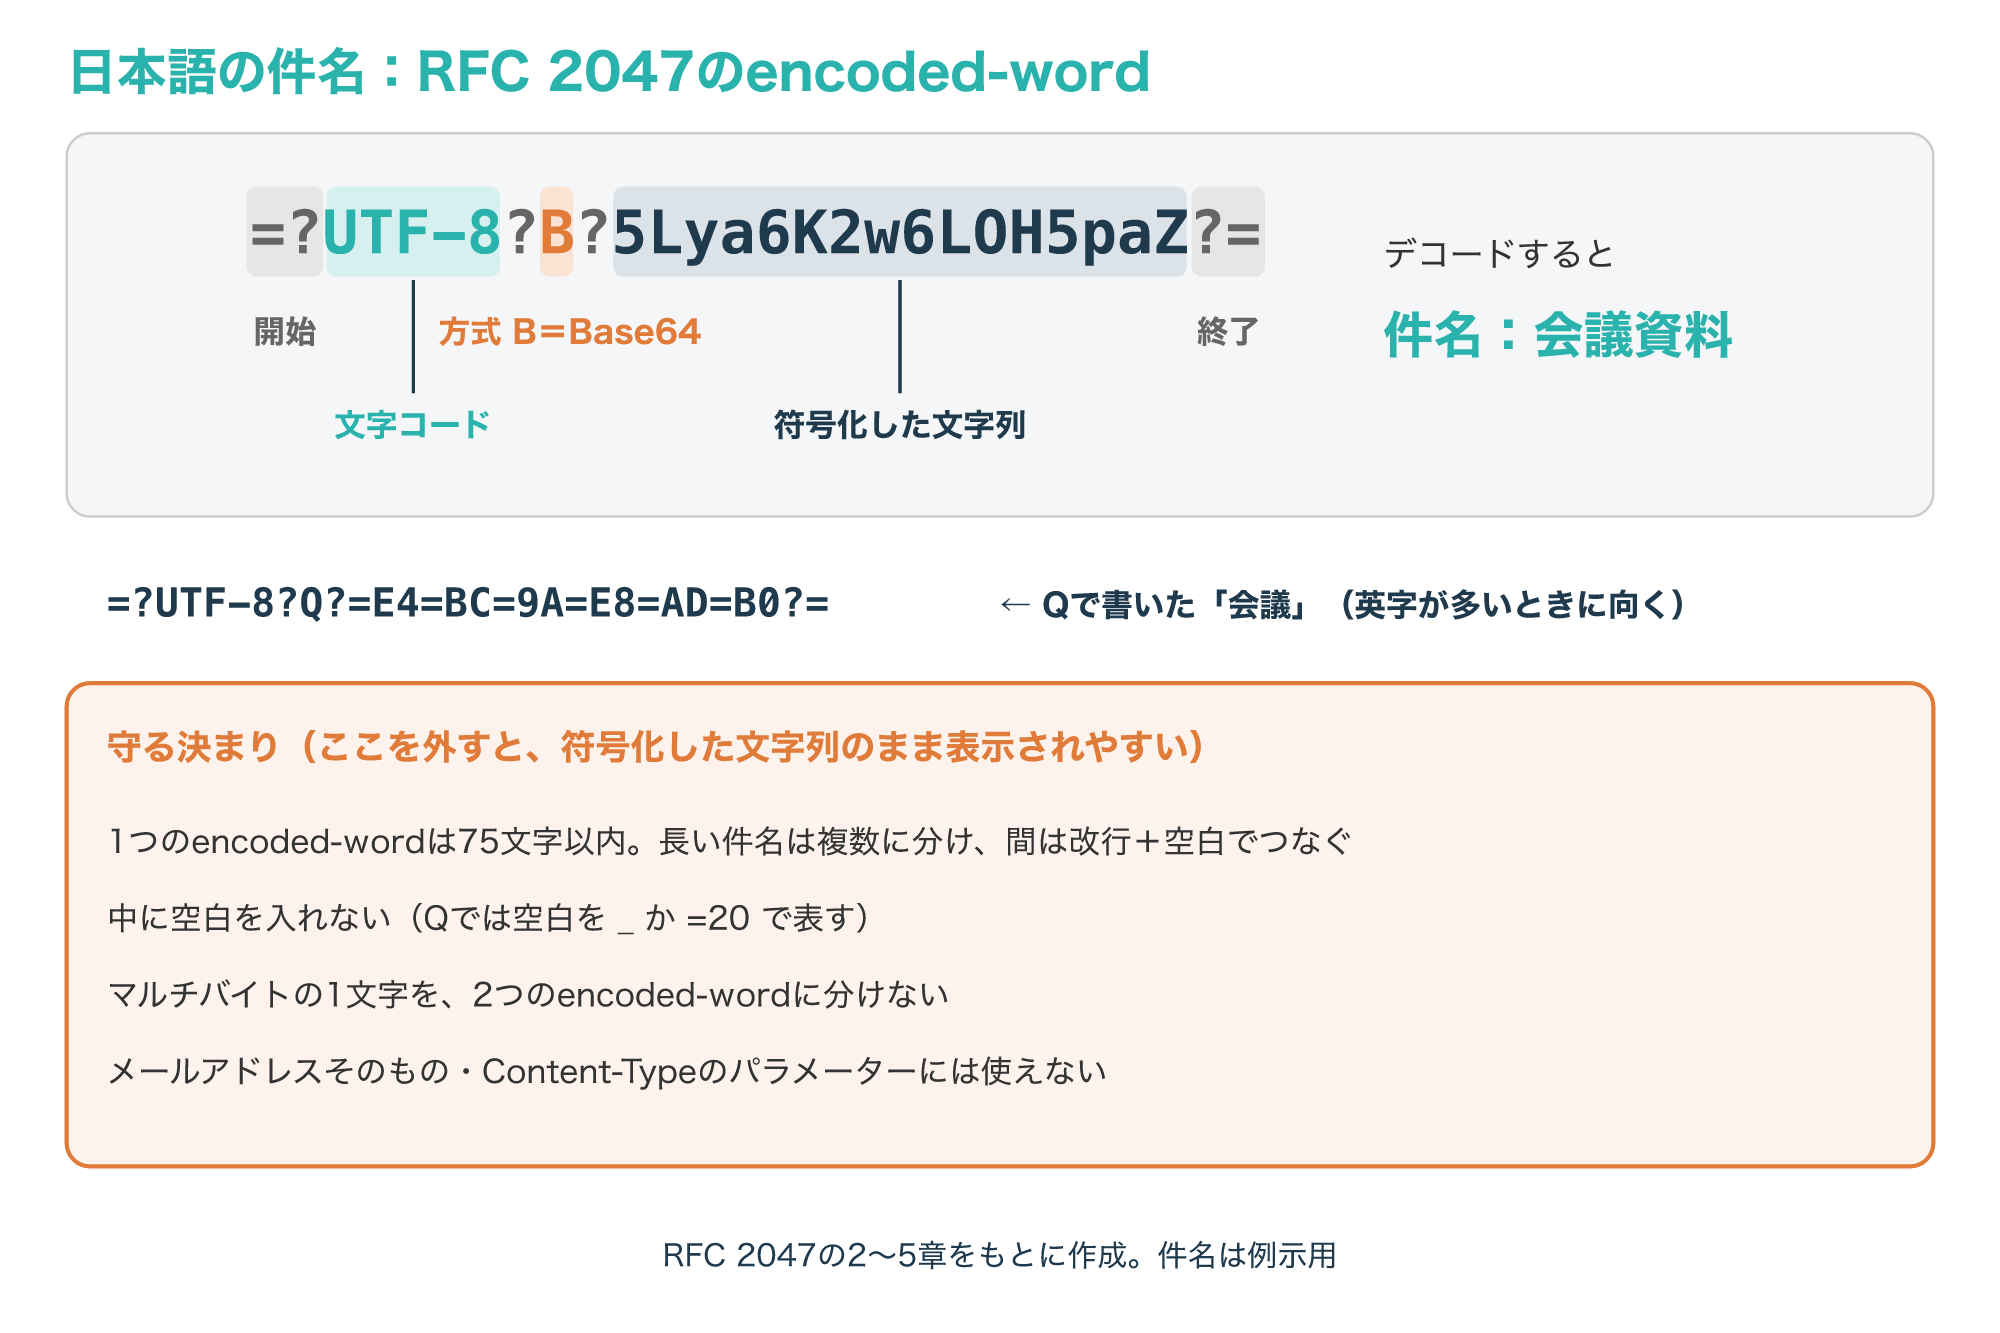
encoded-wordは「=?」で始まり「?=」で終わり、その間に文字コード、符号化の方式、符号化した文字列を「?」で区切って並べます。
符号化の方式にはBase64と同じBと、quoted-printableに似たQの2つがあり、英字が多い文字列ならQ、そうでなければBが勧められています。
1つのencoded-wordは75文字以内で、長い件名は複数のencoded-wordに分け、その間は改行と空白でつなぎます。
encoded-wordの中には空白を入れられず、Qでは空白を「_」か「=20」で表します。
また、マルチバイトの1文字を2つのencoded-wordに分けて入れてはいけません。
encoded-wordを使えるのは件名などのテキストのヘッダー、表示名、コメントで、メールアドレスそのものやContent-Typeのパラメーターには使えません。
受信側はencoded-wordを元の文字コードの文字に戻して表示するため、件名が「=?UTF-8?B?」で始まる文字列のまま見えるときは、書き方の誤りや受信側の非対応が考えられます(参考3)。
WebでのMIMEタイプ:Content-Typeとnosniff
5-1. HTTPレスポンスのContent-Typeとcharset
Webでは、サーバーがHTTPレスポンスのContent-Typeヘッダーで、返すデータのメディアタイプ(MIMEタイプ)を示します。
次の図は、ブラウザがWebサーバーからファイルを受け取るときのレスポンスと、ファイルの種類ごとのContent-Typeの例を示したものです。
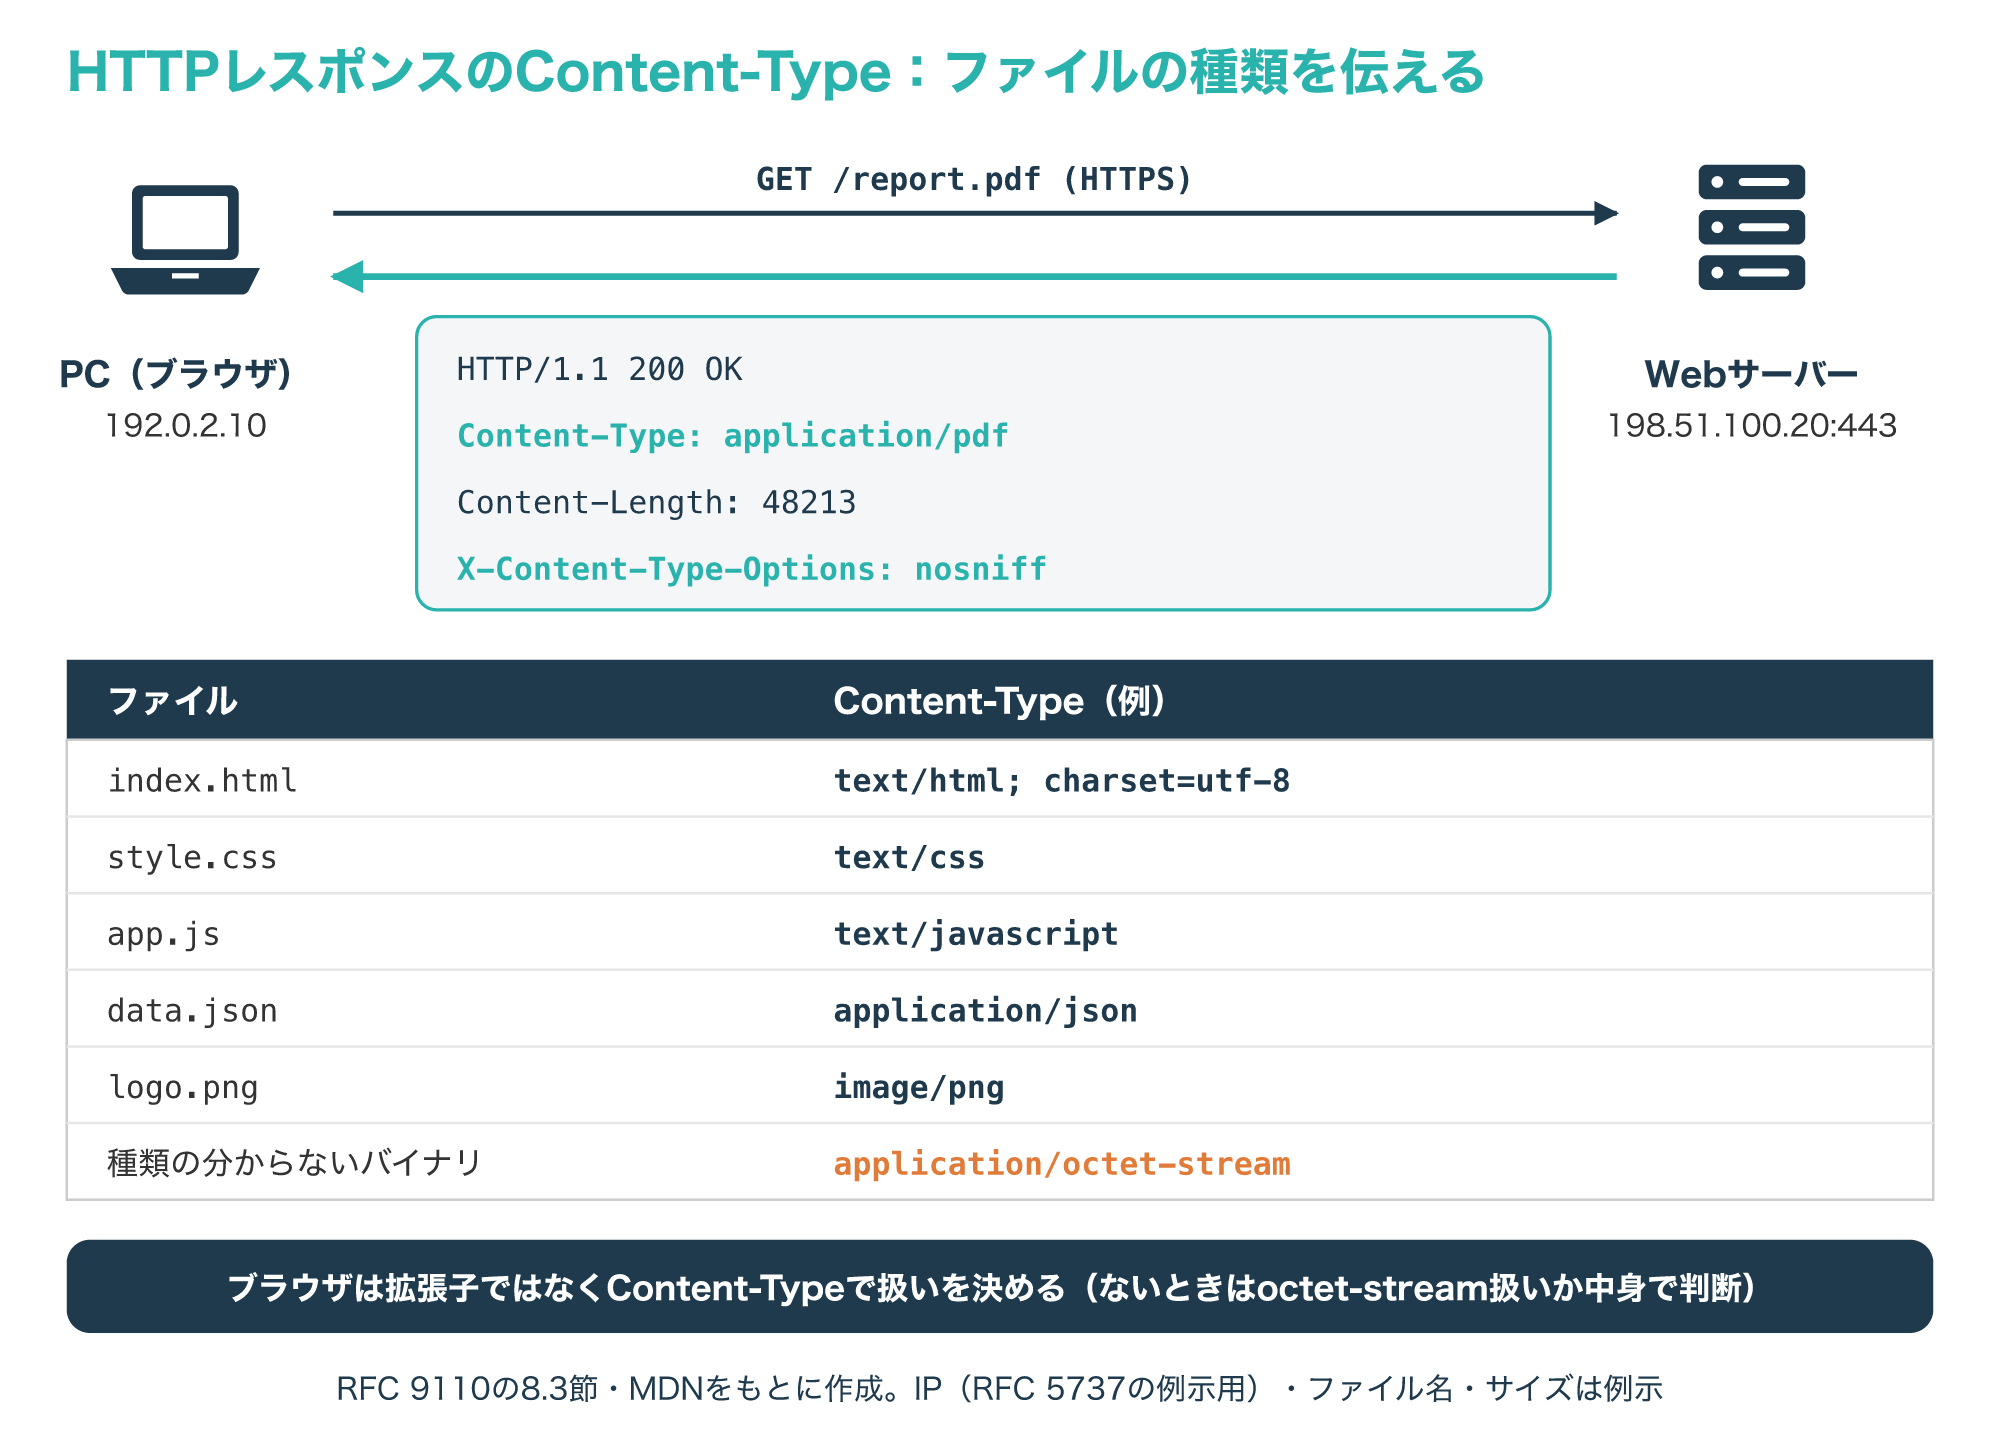
RFC 9110によると、Content-Typeはデータの形式と、受信側がそのデータをどう処理するかを示すもので、値の例は「text/html; charset=ISO-8859-4」です。
「text/html;charset=utf-8」と「text/html; charset=”utf-8″」は同じ意味ですが、RFC 9110は前者の書き方にそろえることを勧めています。
MDNは、ブラウザがファイルの拡張子ではなくMIMEタイプで処理を決めるため、Webサーバーが正しいContent-Typeを送ることが重要だと説明しています。
Content-Typeがないレスポンスでは、受信側はapplication/octet-streamとみなすか、中身を調べて種類を判断してよいとされています。
MDNによると、多くのWebサーバーは認識できないファイルをapplication/octet-streamとして送り、ブラウザはそのファイルをディスクに保存させる扱いにします(参考4・参考6)。
5-2. MIMEスニッフィングとX-Content-Type-Options: nosniff
MIMEスニッフィングとは、Content-Typeがない場合や正しくないと判断した場合に、ブラウザがデータの中身のバイトを見てMIMEタイプを推測する動作のことです。
RFC 9110は、この推測が誤った結論を導き、利用者を新たなセキュリティのリスクにさらすおそれがあると指摘しています。
OWASPのチートシートも、スニッフィングによって実行できないはずのMIMEタイプが実行できるものとして扱われる「MIME Confusion Attacks」を挙げています。
次の図は、利用者がアップロードしたテキストのファイルを、nosniffの有無で比べたものです。
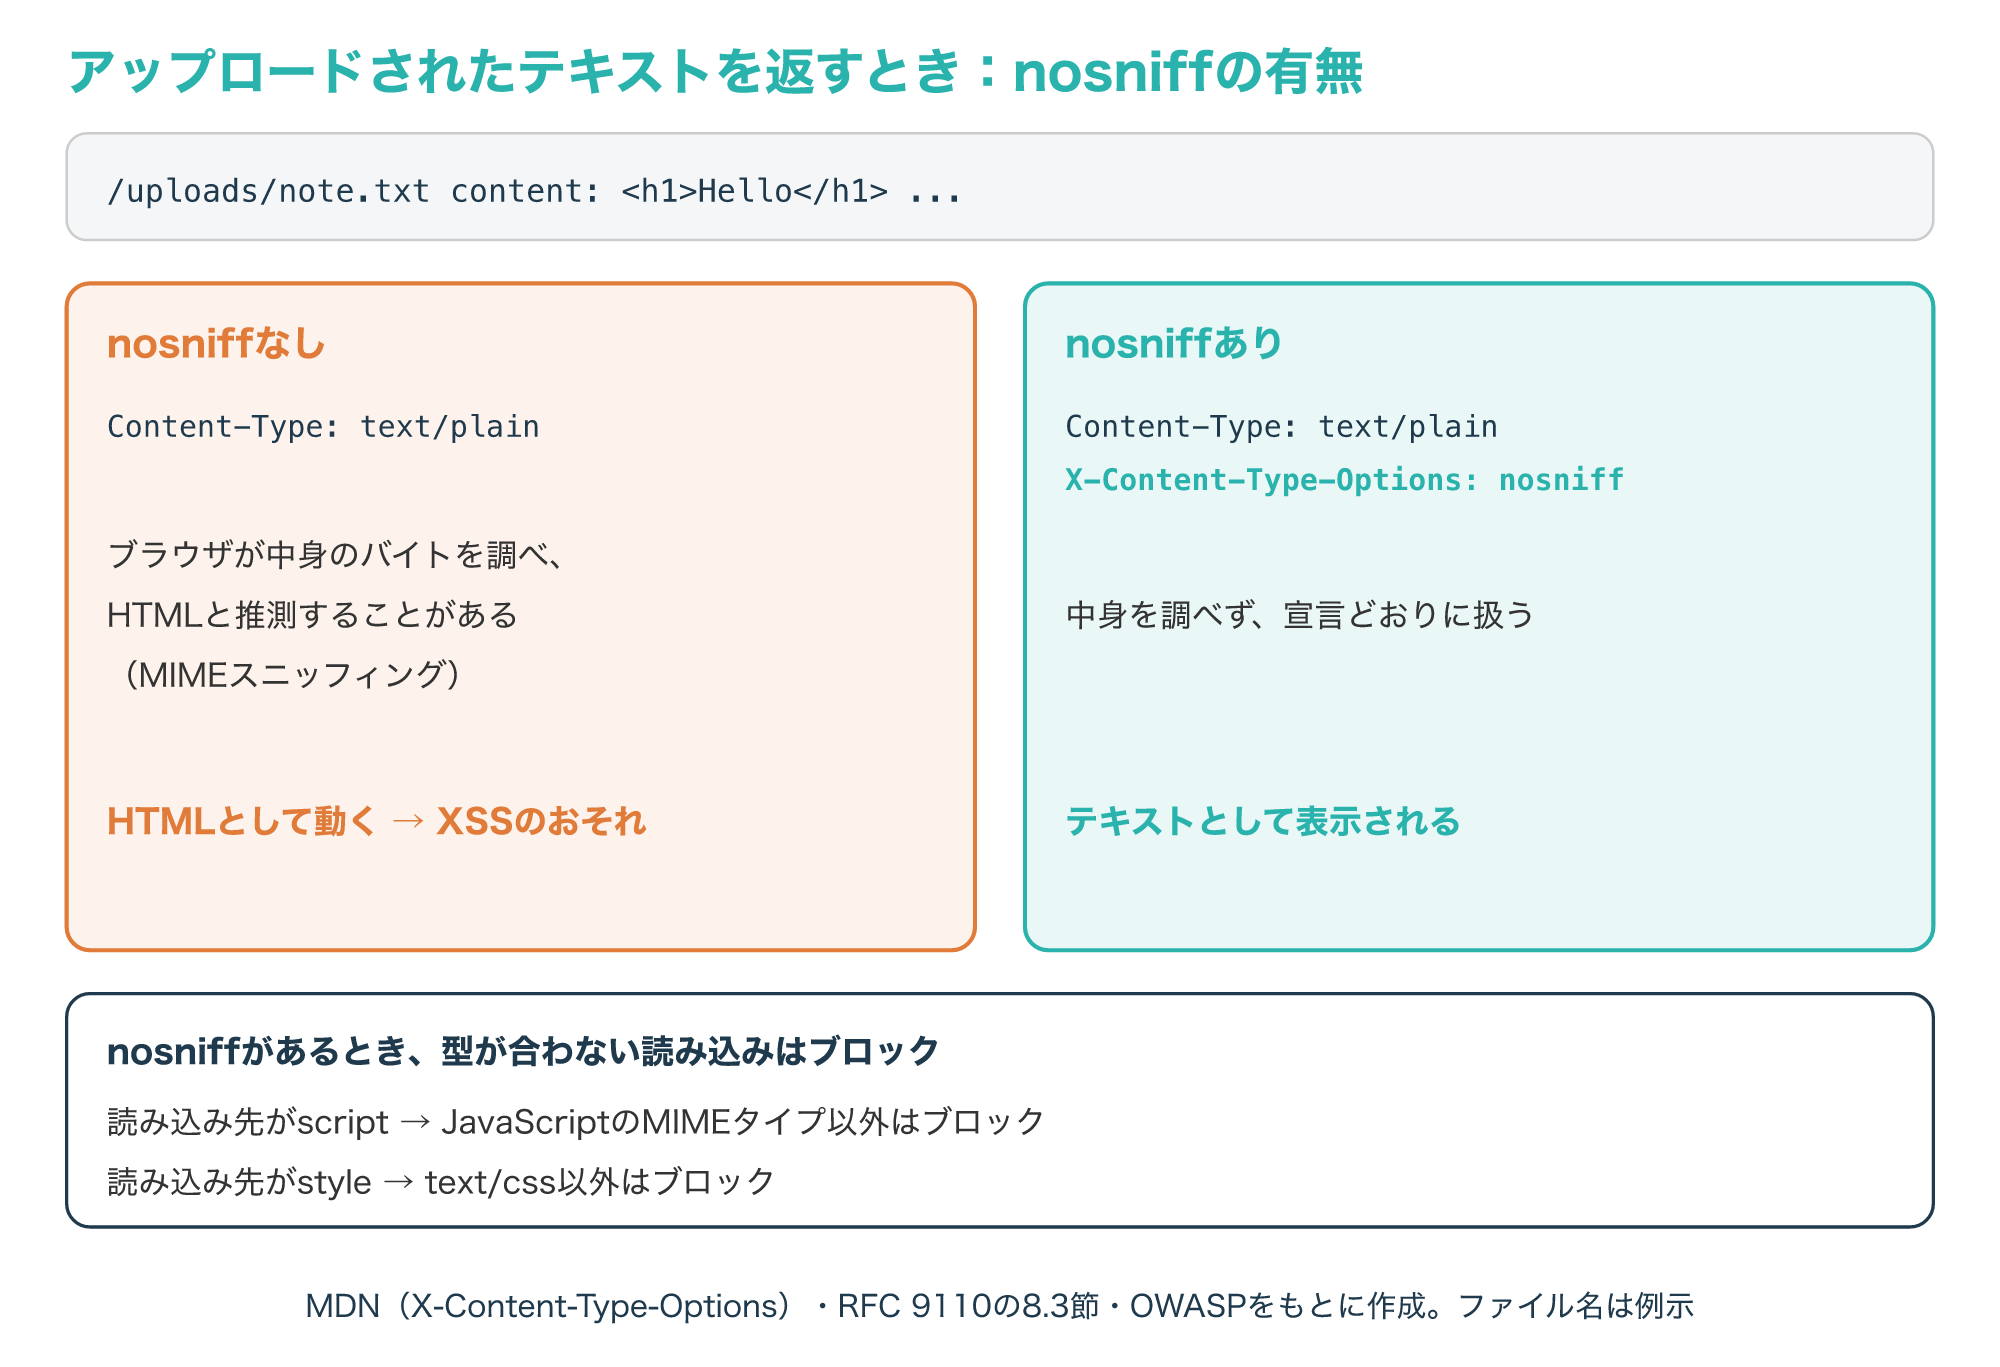
X-Content-Type-Options: nosniffは、Content-Typeで示したMIMEタイプを変えずに使うようブラウザに求めるレスポンスヘッダーです。
MDNによると、nosniffを付けるとブラウザは中身を調べずにContent-Typeの値のまま扱い、例えばtext/plainのレスポンスは、中にHTMLのタグがあってもHTMLとして解釈しません。
MDNは、これにより、テキストとして扱うはずの利用者のアップロードがHTMLとして実行されるXSS(クロスサイトスクリプティング)を防げると説明しています。
また、読み込み先がスクリプトでJavaScriptのMIMEタイプでない場合や、スタイルシートでtext/cssでない場合は、ブラウザがそのレスポンスをブロックします(参考4・参考5・参考7)。
XSSの仕組みと対策は、次の記事で解説しています。
5-3. 誤ったMIMEタイプで起きることと配信の設定
MIMEタイプの誤りは、セキュリティだけでなく、ページの表示や動作の不具合の原因にもなります。
MDNによると、CSSのファイルはtext/cssで送る必要があり、text/plainやapplication/octet-streamで送ると、多くのブラウザはCSSとして認識せずに無視します。
JavaScriptはtext/javascriptで送るべきとされ、歴史的な理由でほかの古い値が受け付けられることはあっても、今後も確実に動くのはtext/javascriptだけとされています。
動画や音声も、正しいMIMEタイプでなければvideo要素やaudio要素で再生されません。
MDNは、Webサーバーが拡張子の.cssを認識しないとCSSをtext/plainなどで送ることがあると説明しており、拡張子とMIMEタイプの対応の設定が誤りの原因になります。
OWASPは、HTMLに文字コードを付けた「Content-Type: text/html; charset=UTF-8」を推奨し、charsetはXSSを防ぐために必要だとしています。
利用者がアップロードしたファイルを配信するときは、Content-Disposition: attachmentでダウンロードさせ、種類の分からないファイルはapplication/octet-streamにし、nosniffを付けることが勧められています(参考6・参考7)。
MIMEの確認方法とトラブルの切り分け
6-1. メールの文字化けや添付の不具合はヘッダーで確かめる
メールの文字化けや添付ファイルの不具合を調べるときは、メールソフトのソースを表示する機能でMIMEのヘッダーを直接見ると、原因を絞り込みやすくなります。
次の図は、よくある症状ごとに、見るべきヘッダーと考えられる原因を並べたものです。
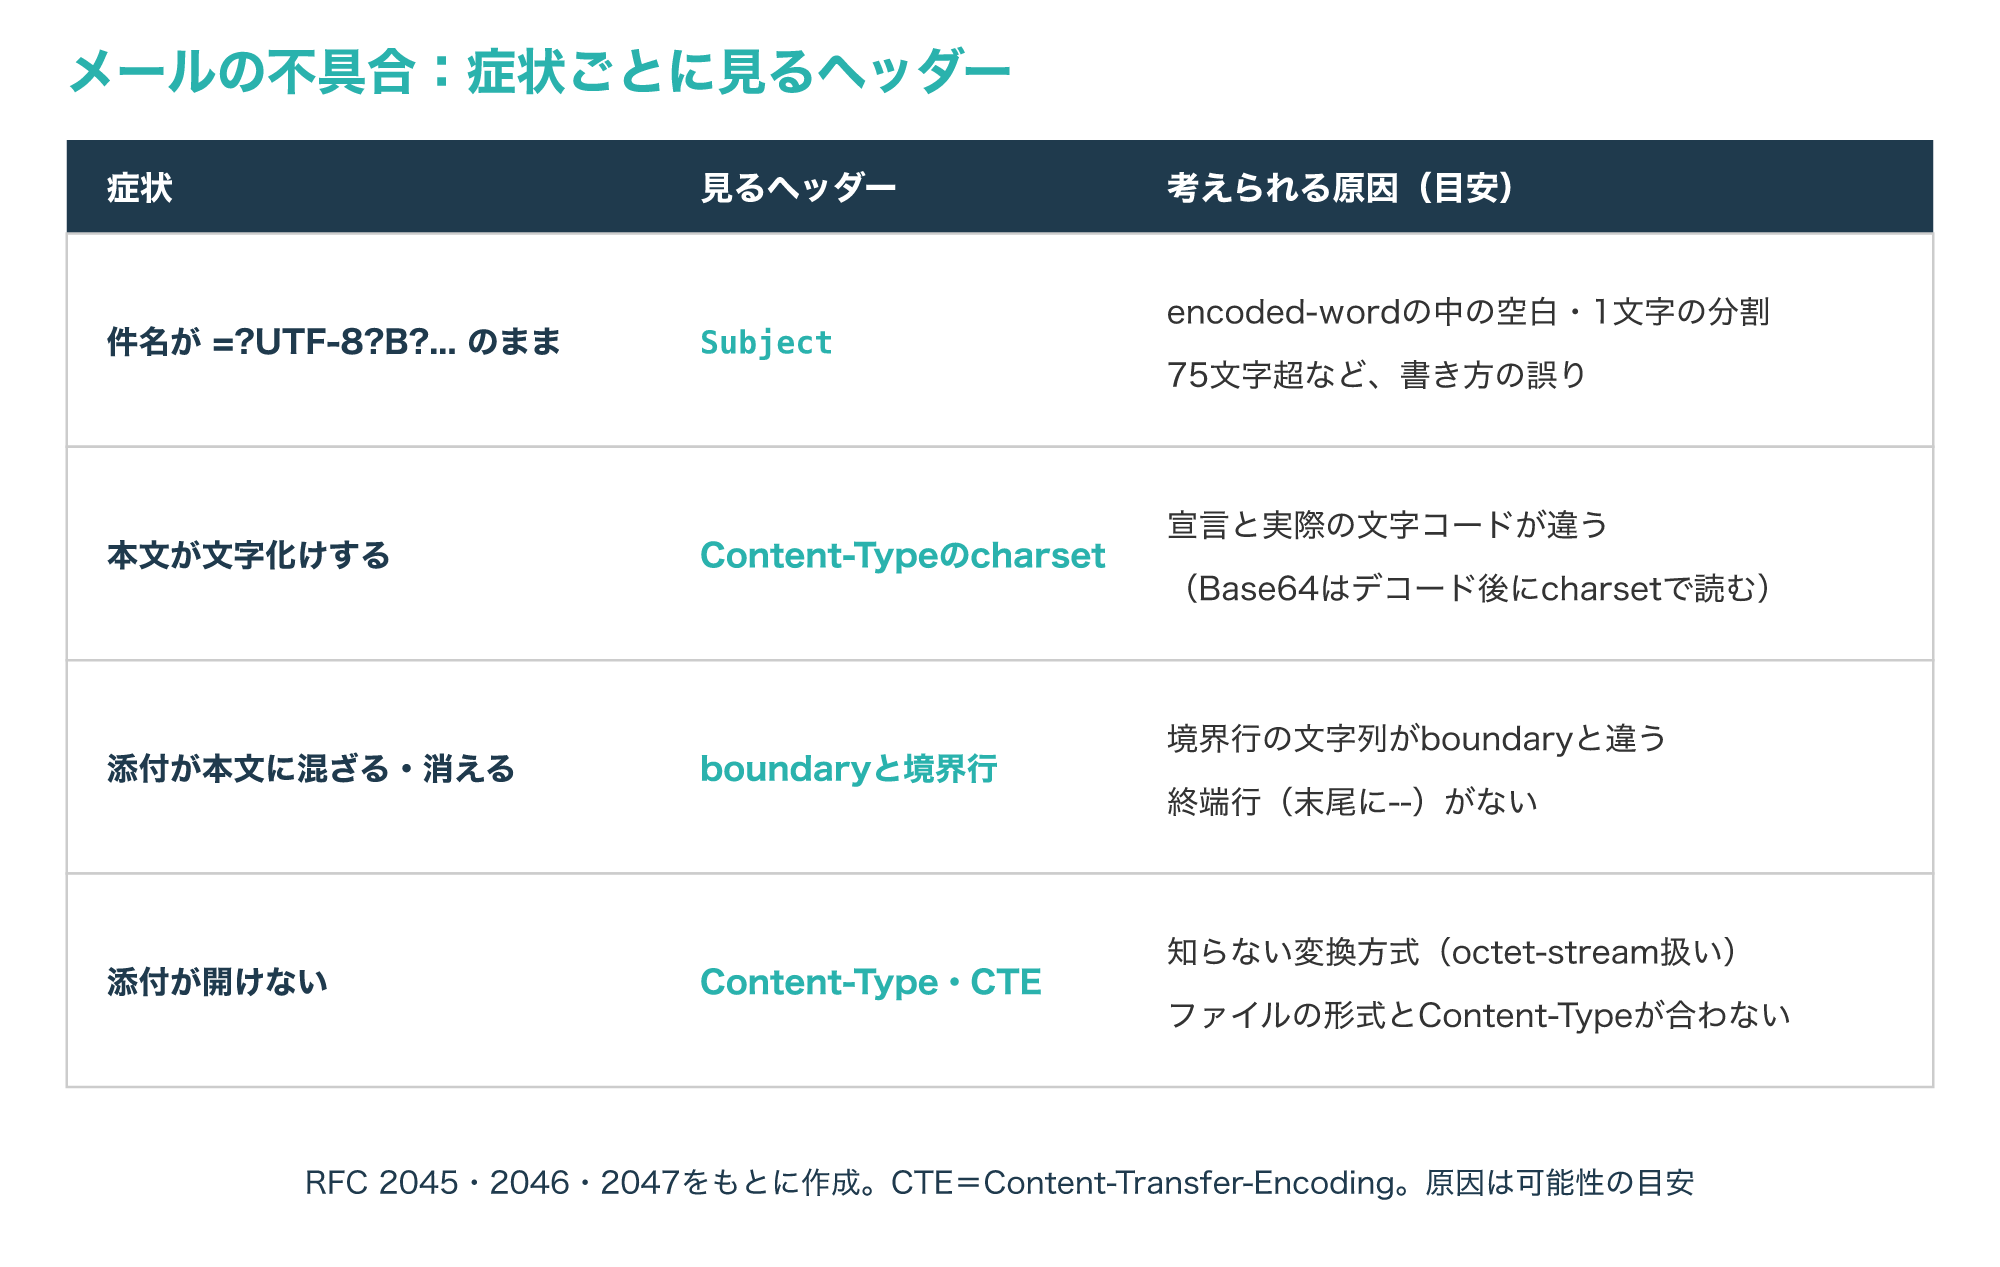
件名が「=?UTF-8?B?」で始まる文字列のまま表示される場合は、encoded-wordの中に空白が入っている、1文字が2つに分かれているなど、RFC 2047の書き方に合っていない可能性があります。
本文が文字化けする場合は、Content-Typeのcharsetと実際の本文の文字コードが合っているかを確かめます。
Base64で変換された本文はデコードした後にcharsetの文字コードとして読まれるため、charsetの宣言が違うと、変換が正しくても文字化けします。
添付ファイルが本文に混ざったり消えたりする場合は、Content-Typeのboundaryの値と境界行の文字列が一致しているか、最後に「–」の付いた終端行があるかを確かめます。
添付ファイルが開けない場合は、Content-TypeとContent-Transfer-Encodingの組み合わせを見て、知らない変換方式が付いていないか、ファイルの形式と合っているかを確かめます(参考1・参考2・参考3)。
6-2. Webの表示の不具合はレスポンスヘッダーで確かめる
Webページの表示がおかしい、CSSやスクリプトが効かないといった場合は、ブラウザの開発者ツールのネットワークの画面で、そのファイルのレスポンスヘッダーを確かめます。
見るのは、Content-Typeの値がファイルの種類と合っているか、テキストのファイルにcharsetが付いているか、X-Content-Type-Options: nosniffが付いているかの3点です。
nosniffを付けた後にCSSやスクリプトが読み込まれなくなった場合は、nosniffを外すのではなく、そのファイルのContent-Typeをtext/cssやtext/javascriptに直します。
MDNは、サイトのセキュリティの検査では、このヘッダーが付いていることと、すべてのリソースのContent-Typeが正しく設定されていることが通常求められると説明しています。
また、RFC 9110によると、Content-Typeが1つのレスポンスに重複して付くと、最後の値を使うなど実装によって扱いが分かれ、相互運用性やセキュリティの問題につながるおそれがあります(参考4・参考5)。
MIMEタイプの誤りはブラウザの推測に任せず、サーバーが返すContent-Typeそのものを直してください。
よくある質問とまとめ
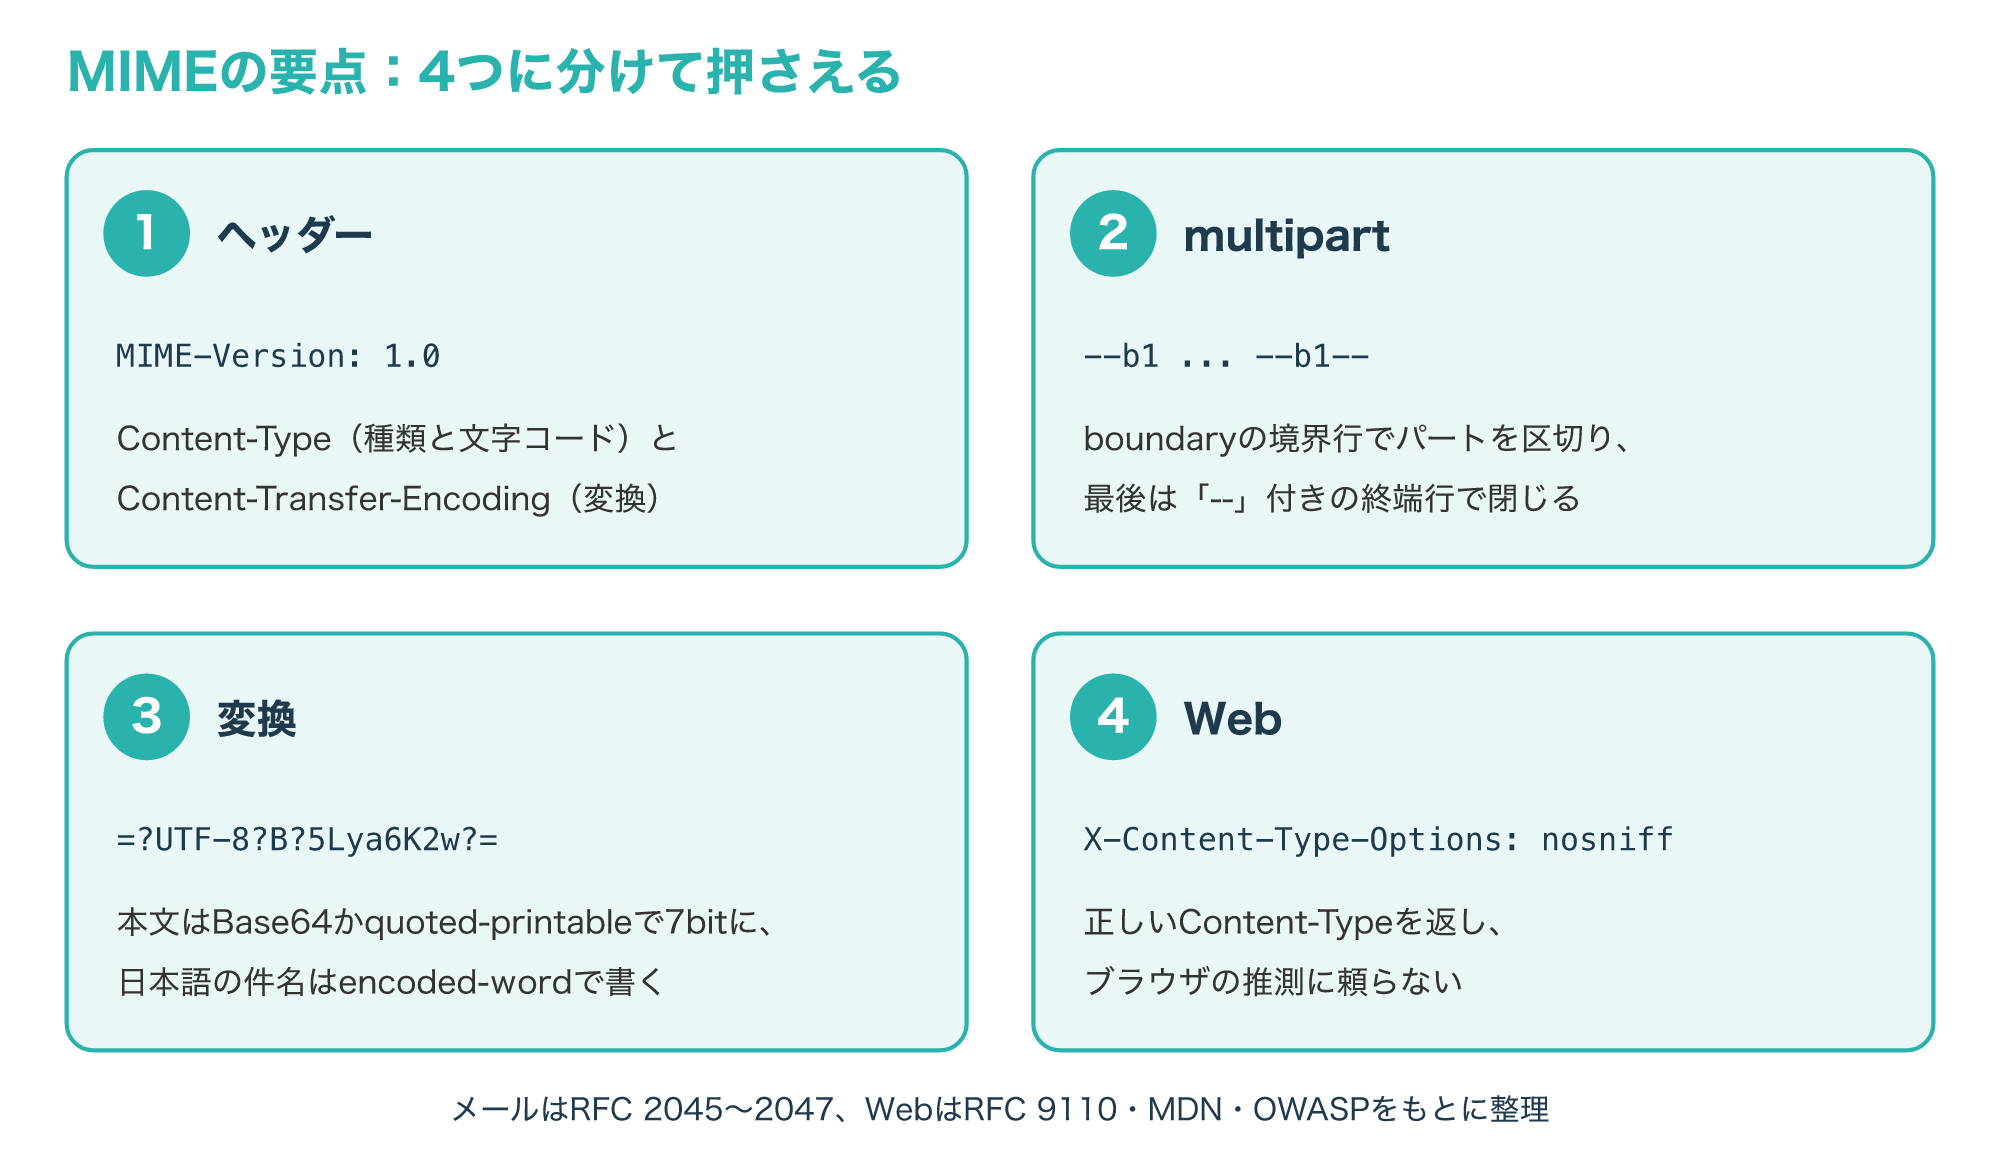
MIMEは、ヘッダー、multipart、本文とヘッダーの変換、WebのMIMEタイプの4つに分けると整理しやすくなります。
次の図は、この記事の要点をまとめたものです。
Q1. MIMEとは何ですか?
英数字のテキストが前提だったメールで、日本語の本文や件名、画像などの添付、複数のパートを送れるようにした拡張仕様で、中心となる仕様は1996年に公開されたRFC 2045〜2049です。
Q2. MIMEタイプとは何ですか?
Content-Typeヘッダーで示すデータの種類で、「text/html」のようにtypeとsubtypeを「/」でつないで書き、現在はメディアタイプとも呼ばれます。
Q3. Base64とquoted-printableはどう使い分けますか?
ほとんどが英数字のテキストならquoted-printable、画像や日本語のように英数字以外が多いデータならBase64が向いています。
Q4. 件名の「=?UTF-8?B?」とは何ですか?
RFC 2047のencoded-wordの始まりで、UTF-8の文字をBase64で変換した件名であることを示し、対応したメールソフトでは元の文字で表示されます。
Q5. X-Content-Type-Options: nosniffは付けた方がよいですか?
OWASPは付けることを推奨しており、付けるときはすべてのファイルのContent-Typeを正しく設定しておく必要があります。
まずは、届いたメールのソースや自分のWebサイトのレスポンスヘッダーで、Content-Typeの値を確かめてみてください。
参考1:RFC 2045: MIME Part One: Format of Internet Message Bodies(RFC Editor、英語)
参考2:RFC 2046: MIME Part Two: Media Types(RFC Editor、英語)
参考3:RFC 2047: MIME Part Three: Message Header Extensions for Non-ASCII Text(RFC Editor、英語)
参考4:RFC 9110: HTTP Semantics(RFC Editor、英語)
参考5:X-Content-Type-Options header(MDN Web Docs、英語)