MTBF・MTTR・MTTFとは?違いと稼働率の計算式を解説
MTBF(平均故障間隔)は故障から次の故障までの平均の稼働時間、MTTR(平均修復時間)は故障してから復旧するまでの平均時間、MTTF(平均故障時間)は修理しない部品が故障するまでの平均時間です。
この記事では3つの違いと計算式、稼働率やSLAとの関係、可用性を高める設計の考え方を図解します。

この記事は以下のような人におすすめ!
- 情報処理試験でMTBFや稼働率の計算問題に取り組んでいる人
- 「MTMF」という言葉を見かけて、正しい用語を確かめたい人
- サーバーやクラウドの稼働率・SLAの目標を決めるIT担当者
MTBF・MTTR・MTTFとは
1-1. 3つの指標の違いを1つの図で理解する
MTBF・MTTR・MTTFは、システムや機器が「どれくらい壊れにくいか」「壊れたらどれくらいで直るか」を数字で表すための、信頼性の指標です。
どれも「Mean Time(平均時間)」で始まる略語で、時間の平均を表している点が共通しています。
違いを理解するいちばんの近道は、1台のサーバーが動いて、止まって、直って、また動くという流れを1本の時間軸に並べてみることです。
次の図は、修理しながら使い続けるサーバーと、修理せずに交換する部品の2つの場合に、それぞれの指標がどの時間を指すかをまとめたものです。
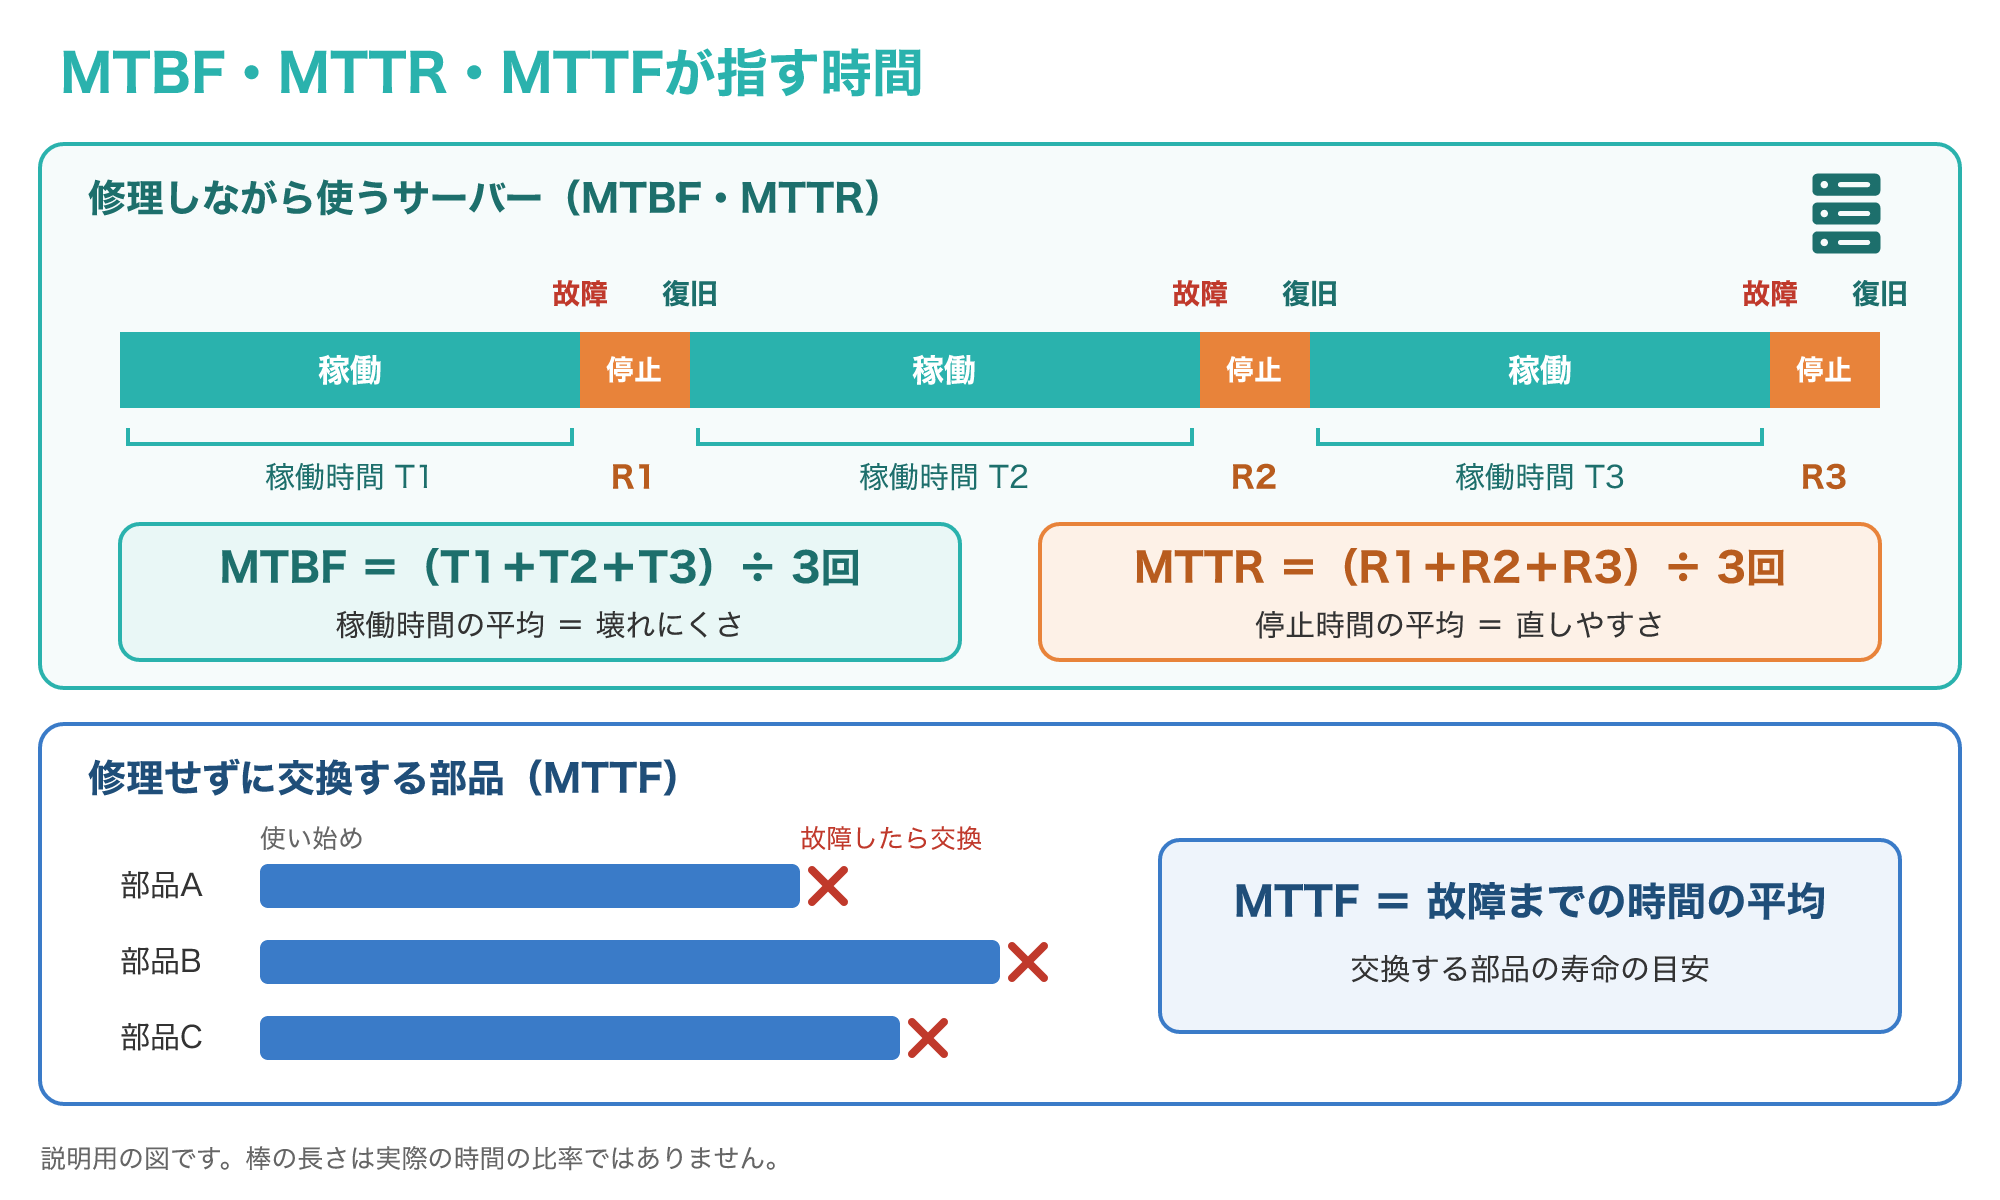
図の上段のように、修理して使い続けるものでは、緑の「稼働」とオレンジの「停止」がくり返されます。
このうち、稼働している時間の長さを平均したものがMTBF、停止している時間の長さを平均したものがMTTRです。
一方、図の下段のように、壊れたら新しいものと交換する部品には「次の故障までの間隔」がないため、使い始めてから壊れるまでの平均時間であるMTTFを使います。
MTBFが長いほど壊れにくく、MTTRが短いほど早く直るので、どちらもシステムが使える時間の割合である「稼働率」を左右します。
MTBFは「壊れにくさ」、MTTRは「直しやすさ」、MTTFは「交換する部品の寿命の目安」を表すと覚えると、3つを区別しやすくなります。
1-2. MTBF・MTTR・MTTFそれぞれの意味と使い分け
MTBFは「Mean Time Between Failures」の略で、日本語では平均故障間隔と呼ばれます。
Microsoftの資料では、MTBFを「ワークロードが失敗するまで、中断することなく期待される機能を実行できる期間」と説明しています。
英語版の同じ資料では「Mean time between failure (MTBF)」と表記されています。
この記事では、試験や実務でよく使われる考え方に合わせて、MTBFを「故障と故障の間に、正常に動いていた時間の平均」として扱います。
MTTRは、故障してから修理や復旧が終わり、再び使えるようになるまでの時間の平均で、日本語では平均修復時間や平均復旧時間と呼ばれます。
英語ではMean Time To Repair(修理)やMean Time To Recover(復旧)と書かれ、Microsoftの資料は後者の表記を使っています(参考2)。
同じ資料の日本語版は、MTTRを「故障が検出された後にコンポーネントを復元するのにかかった時間」と説明しています(参考1)。
このように、故障が起きてから気づくまでの時間をMTTRに含めるかどうかは資料や組織によって異なるため、実際に測るときは「どこから数えるか」を先に決めておくことが大切です。
何を「故障」として数えるかも、事前に決めておきたいポイントです。
Microsoftの資料は、システムが正常に機能し続けられなくなる予期しないイベントを「障害」、通常の操作で想定されすぐに処理できるものを「エラー」と区別しています(参考5)。
MTTFは「Mean Time To Failure」の略で、一般に、修理せずに交換する部品や製品が、使い始めてから故障するまでの時間の平均を表します。
3つの指標の違いを、表にまとめます。
| 指標 | 日本語の呼び方 | 表す時間 | 主な対象 |
|---|---|---|---|
| MTBF | 平均故障間隔 | 故障から次の故障までの稼働時間の平均 | 修理して使い続けるシステムや機器 |
| MTTR | 平均修復時間 | 故障してから復旧するまでの時間の平均 | 修理して使い続けるシステムや機器 |
| MTTF | 平均故障時間 | 使い始めてから故障するまでの時間の平均 | 修理せずに交換する部品や製品 |
どの指標も平均値なので、たとえばMTBFが1万時間の機器でも、1万時間まで必ず壊れないという意味ではありません。
実際には早く壊れるものも長く動くものもあり、それらを平均した結果がMTBFやMTTFになると考えてください。
「MTMF」という用語について
2-1. MTMFは一般的な信頼性の用語ではない
「MTMF」や「MTMF 故障率」という言葉で調べてこの記事にたどり着いた人もいるかもしれません。
MTMFは、信頼性の分野で一般的に使われている用語ではなく、多くの場合はMTBFの誤記だと考えられます。
この記事で確認したMicrosoftの信頼性の資料(参考1〜6)でも、信頼性の指標として挙がっているのはMTBFやMTTR、RTO、RPOで、MTMFという指標は出てきません。
実は、このサイトでも以前「MTMF故障率」という記事を公開していましたが、一般的な用語ではなかったため内容を見直し、正しい用語で説明するこの記事にまとめ直しました。
以前の記事を読んでくださった方には、ご迷惑をおかけしたことをおわびします。
「故障率」を知りたい場合は、MTBFから求められるので、3-1で計算のしかたを紹介します。
資料や問題文で「MTMF」を見かけたら、まずMTBFの誤記ではないかを疑い、その資料の中で定義がどう書かれているかを確かめてください。
2-2. 正確な定義を確かめたいときの確認先
信頼性の用語は、日本ではJIS Z 8115(ディペンダビリティ(総合信頼性)用語)、国際的にはIEC 60050-192(国際電気標準用語の信頼性の部)といった規格で定められています。
この記事は、これらの規格の本文を直接確認したものではなく、Microsoftの公開資料と一般的な説明にもとづいて書いています。
規格によって日本語の訳語や定義の細かな部分が異なる場合があるため、契約書や設計書で厳密な定義が必要なときは、規格の原文を確認してください。
情報処理技術者試験の問題では、問題文の中で各用語の意味や前提が示されることが多いので、まずは問題文の定義に従って計算するのが確実です。
社内でMTBFやMTTRを報告するときも、「何を故障とみなすか」「どこからどこまでを復旧時間とするか」を文書にしておくと、数字の比較がぶれにくくなります。
MTBF・MTTRと稼働率の計算方法
3-1. MTBFとMTTRの求め方
MTBFとMTTRは、一定の期間に記録した稼働時間と停止時間から、次のように計算できます。
- MTBF = 稼働時間の合計 ÷ 故障の回数
- MTTR = 停止時間(修理・復旧にかかった時間)の合計 ÷ 故障の回数
例として、あるサーバーが1年間(8,760時間)に3回故障し、止まっていた時間が合計6時間だったとします。
稼働していた時間は8,760時間から6時間を引いた8,754時間なので、MTBFは8,754 ÷ 3 = 2,918時間になります。
MTTRは、停止時間の合計6時間を3回で割って、2時間です。
故障の起こりやすさを表す「故障率」は、故障の起こりやすさが時間によって変わらないと考える場合、MTBFの逆数(1 ÷ MTBF)で表せます。
この例では1 ÷ 2,918で、1時間あたりの故障率は約0.00034回、言い換えると約2,918時間に1回の割合で故障すると見込むことになります。
実際の機器では、使い始めの初期不良や、長く使ったあとの劣化で故障率が変わるため、この計算はあくまで目安だと考えてください。
また、MTBFやMTTRは記録した期間と件数に左右されるため、故障が1〜2回しかない短い期間の数字だけで判断しないことも大切です。
3-2. 稼働率の計算式と計算例
稼働率は、ある期間のうち、システムが使える状態だった時間の割合で、可用性やアップタイムとも呼ばれます。
いちばん基本の考え方は「稼働率 = 稼働していた時間 ÷(稼働していた時間 + 止まっていた時間)」です。
稼働と停止のくり返しを1回ずつの平均で考えると、稼働の平均がMTBF、停止の平均がMTTRなので、この式は「稼働率 = MTBF ÷(MTBF + MTTR)」と書き換えられます。
次の図は、3-1の例の数字を使って、稼働率を計算する流れを示したものです。
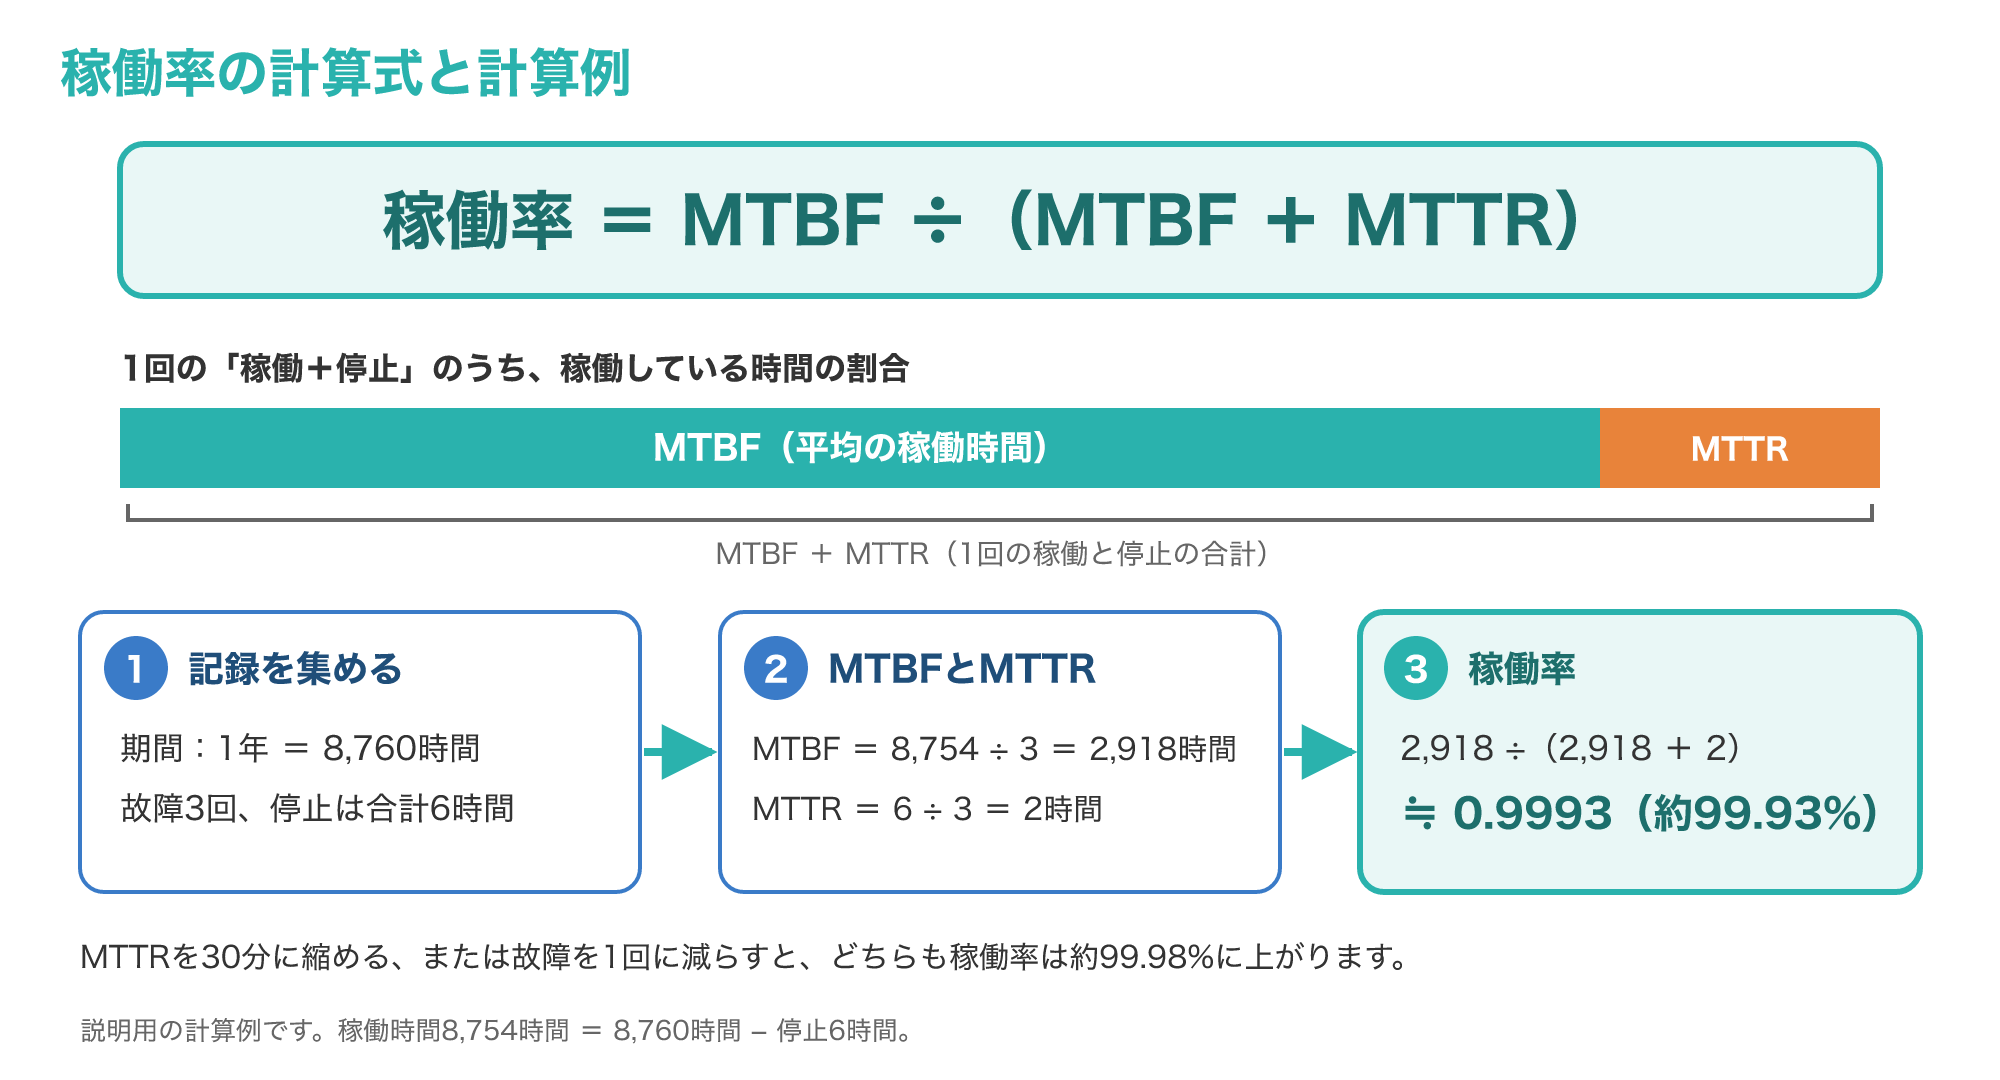
3-1の例に当てはめると、2,918 ÷(2,918 + 2)= 2,918 ÷ 2,920で、稼働率は約0.9993、つまり約99.93%です。
年間の時間で直接計算しても、8,754 ÷ 8,760で約99.93%となり、同じ結果になります。
この式からわかるとおり、稼働率を上げる方法は「MTBFを延ばす(故障を減らす)」か「MTTRを縮める(早く直す)」かの2つに分けて考えられます。
たとえば同じ例で、復旧の手順を整えてMTTRを2時間から30分に縮めると、年間の停止は1.5時間になり、稼働率は約99.98%に上がります。
反対に、故障の回数を3回から1回に減らせた場合も、停止は2時間になり、稼働率は約99.98%です。
どちらの方法が現実的かはシステムによって異なるため、5章で設計の考え方を説明します。
3-3. 直列と並列のシステムの稼働率
実際のシステムは、Webサーバーやデータベース、ネットワーク機器など、複数の部品の組み合わせで動いています。
部品のつなぎ方には、どれか1つでも止まると全体が止まる「直列」と、どれか1つが動いていれば全体が動く「並列」があります。
次の図は、稼働率99.9%の部品を直列につないだ場合と、稼働率99%の部品を並列につないだ場合の計算をまとめたものです。
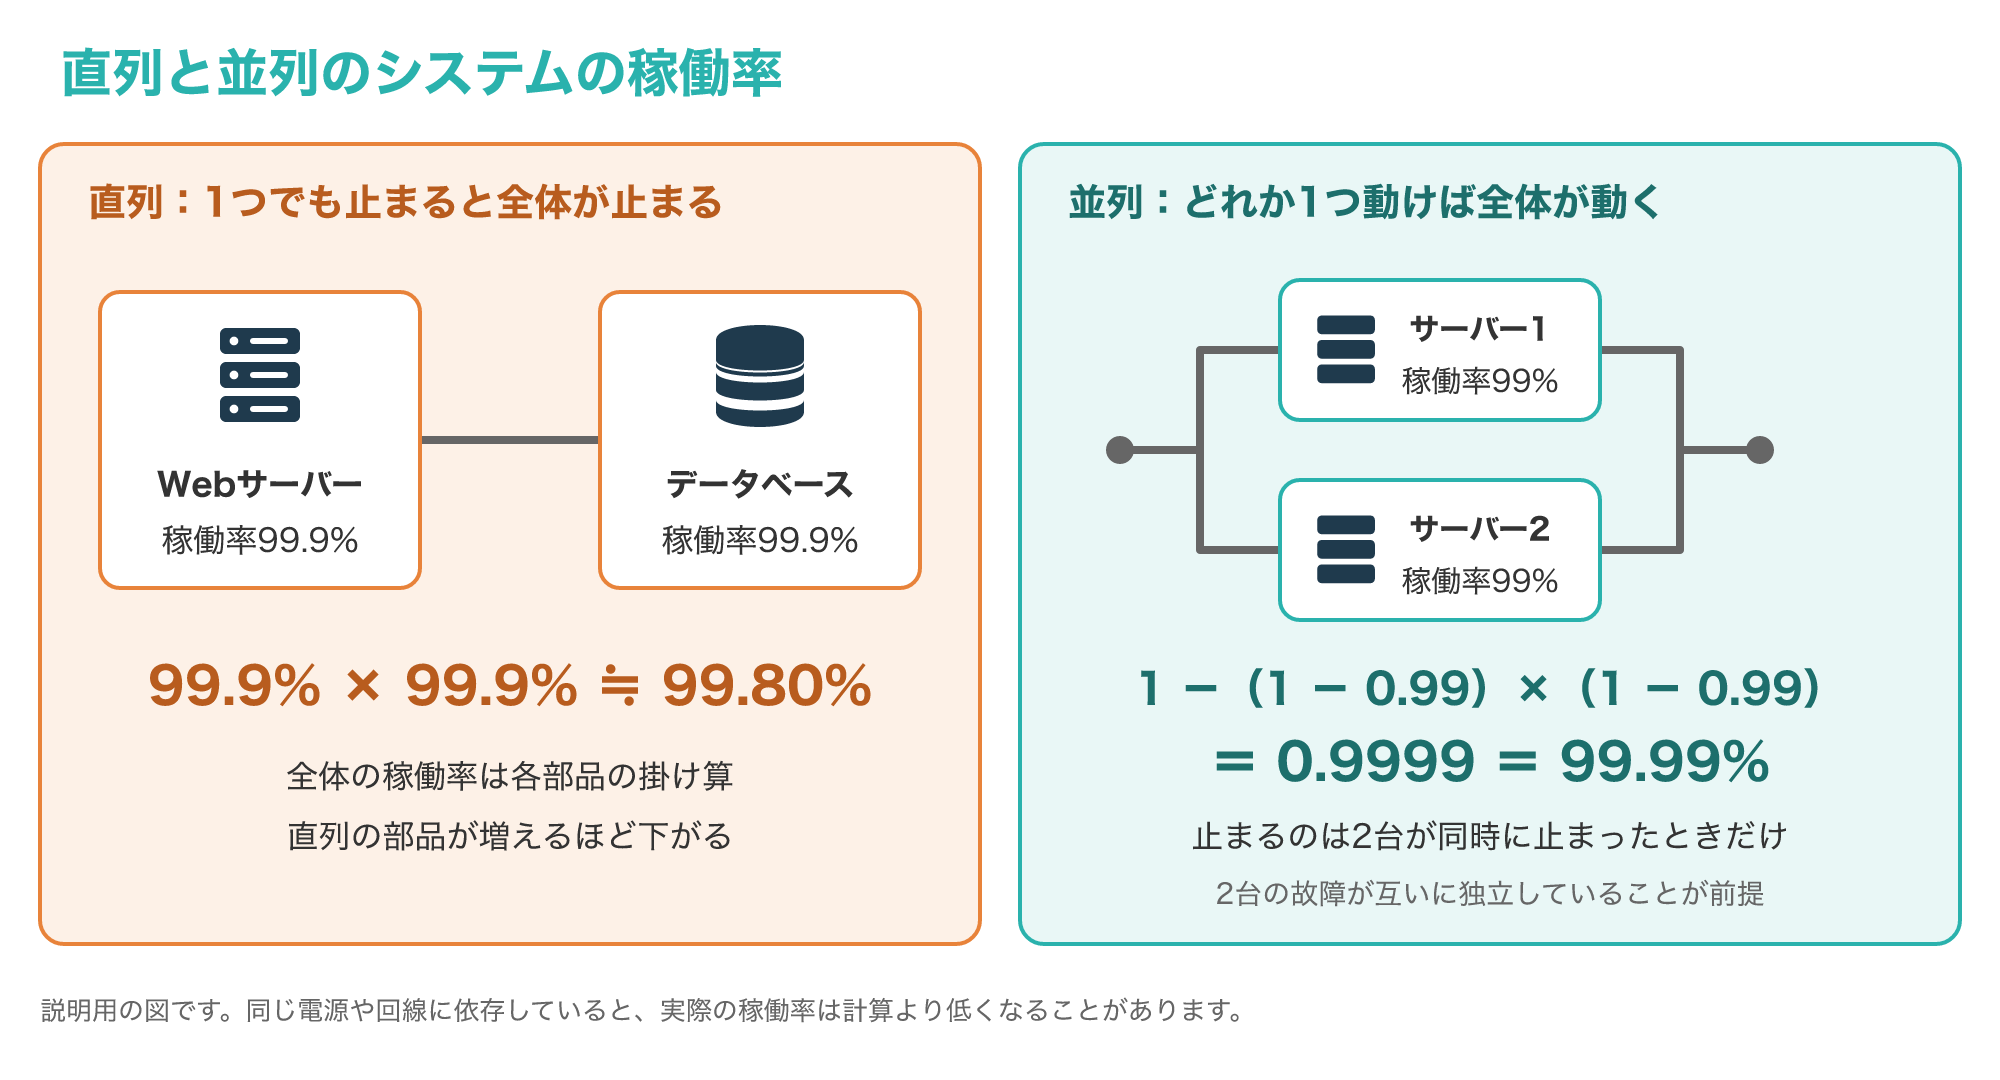
直列の場合、全体の稼働率は各部品の稼働率の掛け算になるので、99.9% × 99.9%で約99.80%と、部品1つのときより下がります。
Microsoftの資料も、複数の要素からなる全体の目標値(複合SLO)は各要素の値の積で求め、例として「99.95% × 99.99999% = 約99.95%」を挙げています。
同じ資料は、外部のサービスや共有の基盤も、利用者の体験や重要な処理に直接影響するなら、この掛け算に含めるよう求めています(参考1)。
並列の場合、全体が止まるのは2台が同時に止まったときだけなので、稼働率は「1 −(1 − 0.99)×(1 − 0.99)」で計算でき、99.99%になります。
ただし、この並列の計算は、2台が同じ原因で同時に壊れない(故障が互いに独立している)ことを前提にしています。
同じ電源や同じネットワークにつながっていると、1つの原因で2台とも止まることがあるため、実際の稼働率は計算より低くなる可能性があります。
電源や回線、空調まで二重化された設備については、データセンターの記事で解説しています。
情報処理試験では、直列は「掛け算」、並列は「1から、全部が止まる確率を引く」と覚えておくと、組み合わせの問題も順番に解けます。
稼働率とSLAの関係
4-1. 稼働率の「9の数」と許容される停止時間
稼働率は、99.9%を「スリーナイン」、99.99%を「フォーナイン」と呼ぶように、9の数で表されることがよくあります。
Microsoftの資料は、アップタイムは一般に「9の数」にもとづく稼働率のパーセンテージで測定され、その割合は一定期間に許容される停止時間の量に関係すると説明しています。
次の表は、Microsoftの資料に載っている、稼働率の目標ごとに1か月と1年で許容される停止時間の目安です。
| 稼働率の目標 | 1か月あたりの停止時間 | 1年あたりの停止時間 |
|---|---|---|
| 99% | 7.20時間 | 3.65日 |
| 99.9% | 43.20分 | 8.76時間 |
| 99.95% | 21.60分 | 4.38時間 |
| 99.99% | 4.32分 | 52.56分 |
| 99.999% | 25.90秒 | 5.26分 |
表のとおり、9が1つ増えるごとに許される停止時間はおよそ10分の1になります。
同じ資料は、長い停止が許されないミッションクリティカルなシステムでは、SLOは通常99.999%(ファイブナイン)を目標にするとも説明しています(参考1)。
3-2の例の約99.93%は、表の99.9%と99.95%の間にあたり、1年で約6時間止まる計算です。
別の資料も、アップタイムの要件が高いほど障害への許容度が低くなり、その稼働率を達成するために必要な作業が増えると述べています。
また、アップタイムはノードのような1つの部品ではなく、ワークロード全体の可用性で測るとされています。
同じ資料は、高可用性を「一時的な障害や断続的な障害が起きても、必要なレベルのアップタイムを日常的に維持できる状態」と説明しています(参考3)。
4-2. SLA・SLOとの違いと、SLAを読むときの注意点
クラウドサービスやデータセンターの契約では、稼働率がSLA(サービスレベル契約)の数値として示されることがよくあります。
Microsoftの資料によると、SLAはサービスの提供者と利用者の間の契約で、守られなかった場合は提供者に金銭的な影響が生じることがあります。
これに対してSLO(サービスレベル目標)は、提供者が自分のシステムに設定する、測定できる目標値です。
SLOの達成度を測るための具体的な測定値は、SLI(サービスレベル指標)と呼ばれます。
同じ資料は、SLAは顧客との正式な契約で財務や法律の面で直接の影響があり、SLOは停止が許容範囲かどうかを社内で評価するために使うものだと、両者の違いを強調しています。
資料の例では、システムのSLOを月99.45%と見積もったうえで、事業の判断として、顧客と約束するSLAを月99.90%に設定しています。
このように、SLAの数字は「実際に出せる稼働率」ではなく、補償を含めた契約上の約束であることがある点に注意が必要です。
SLAを読むときは、その数字がサービスのどの機能を対象にしているかも確かめましょう。
Microsoftの資料は、SLAはサービス全体を保証するものではないので、公表されている稼働率がどの範囲を対象にしているかを十分に理解するよう求めています。
さらに、MTBFはクラウドのサービスでは利用者に知らされないまま故障と復旧が起きることがあり、定義も保証も難しいため、目標は自分で管理できる部品だけを対象にするよう注記しています(参考1)。
SaaSの契約前に確認したいSLAの項目は、次の記事でくわしく解説しています。
SLAの稼働率は契約上の約束で、自社システムの稼働率は、SLAに頼り切らず、依存するサービスを含めた全体の掛け算で見積もることが大切です。
MTBFとMTTRで考える可用性の設計
5-1. MTBFを延ばす:故障を減らし、冗長化する
3-2で見たとおり、稼働率を上げる方法は、MTBFを延ばす方向と、MTTRを縮める方向の2つに分けられます。
次の図は、それぞれの方向で取れる主な対策を整理したものです。
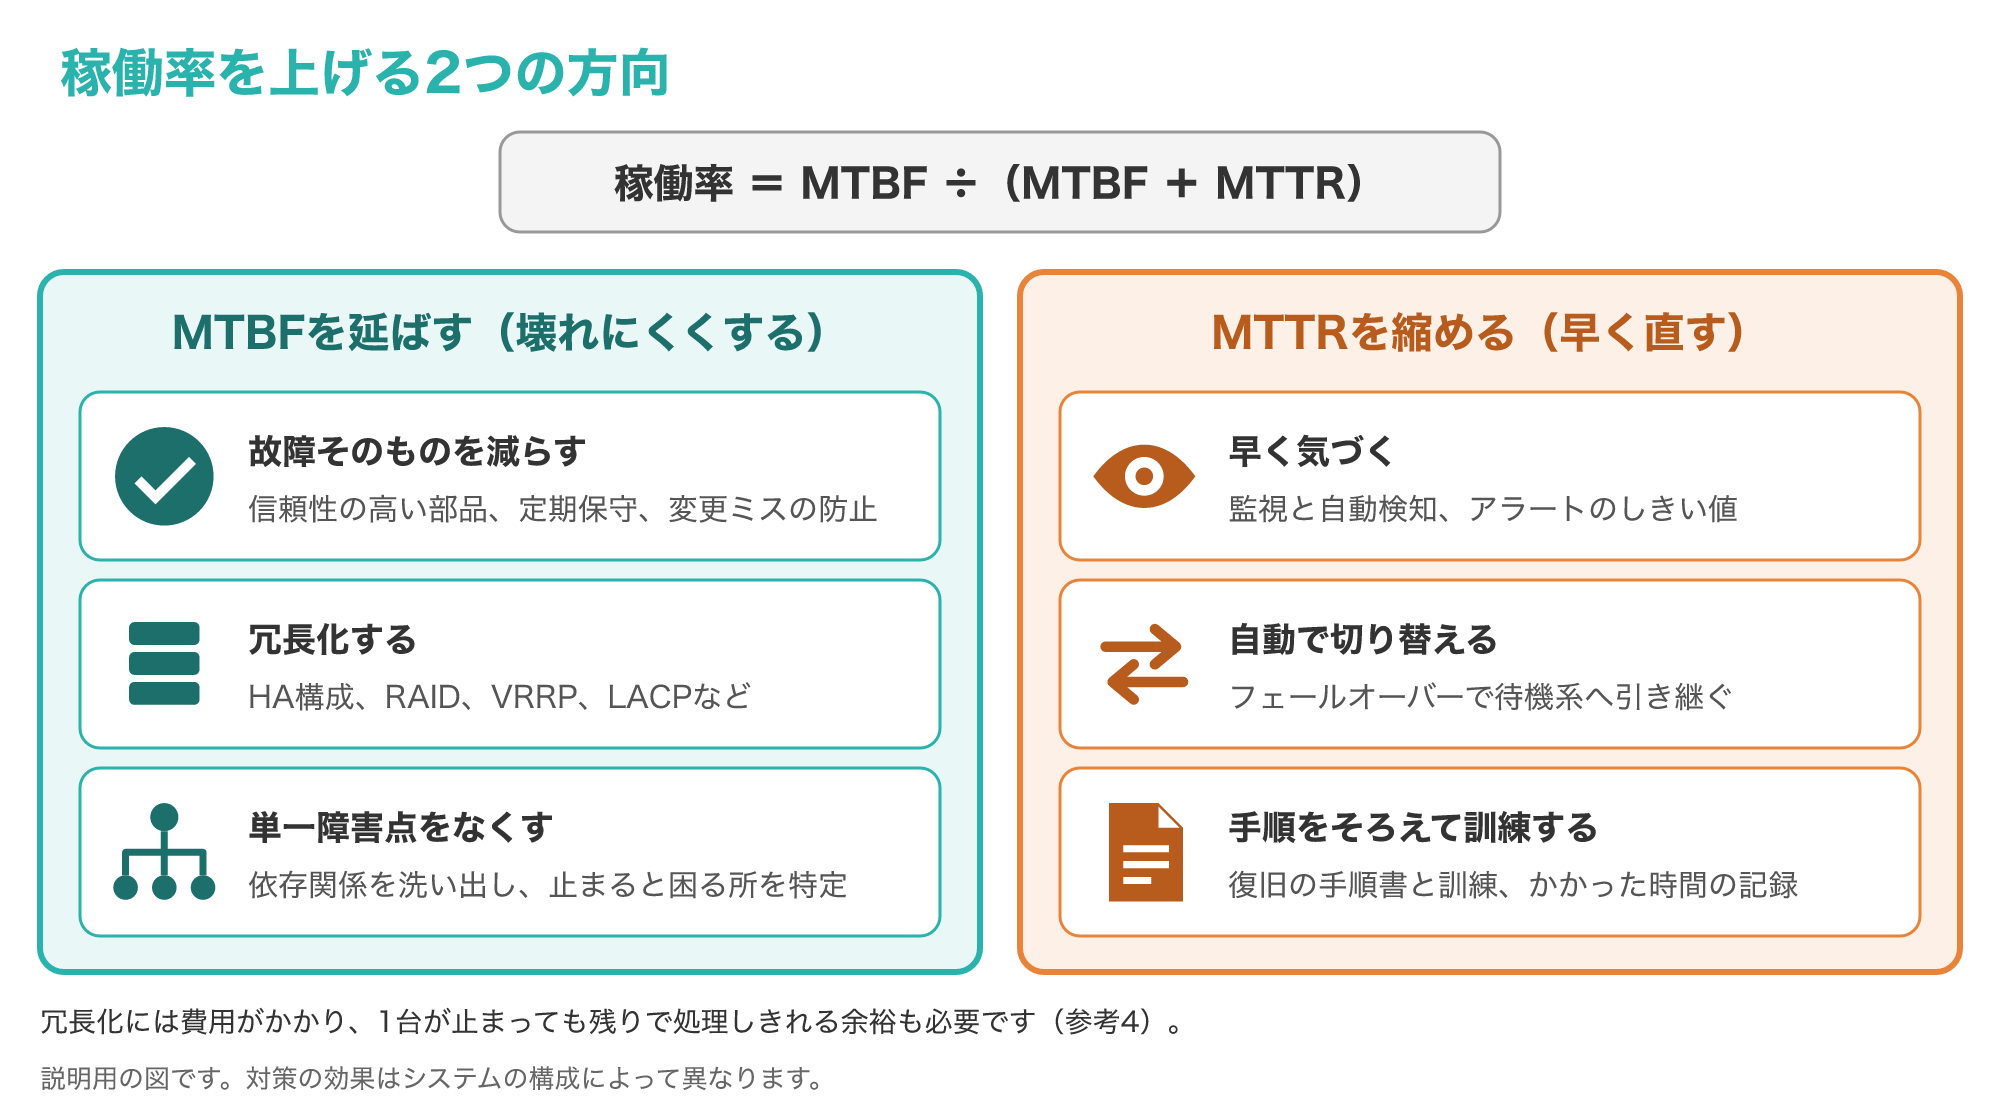
MTBFを延ばすには、まず故障そのものを減らすことが基本で、信頼性の高い部品を選ぶ、定期的に保守する、変更作業のミスを防ぐといった対策があります。
さらに、部品が1つ壊れてもシステム全体は止まらないようにする「冗長化」を組み合わせると、利用者から見た故障の間隔を大きく延ばせます。
Microsoftの資料は、冗長性によって1つのリソースに影響する問題を封じ込め、システム全体の信頼性に影響しないようにすると説明しています。
冗長化を考えるときは、そこが止まると全体が止まってしまう「単一障害点」を見つけることから始めます。
別の資料は、ワークロードの依存関係を洗い出して、単一障害点の分析を行うよう勧めています(参考5)。
サーバーを複数台で動かし、障害時に別のノードへ処理を引き継ぐ構成の例として、Windows Serverのフェールオーバークラスタリングがあります。
この資料によると、1つ以上のノードに障害が起きた場合、残りのノードが処理を自動的に引き継ぎ、中断を最小限に抑えます。
同じ資料は、すべてのノードが同時に処理するアクティブ/アクティブと、一部のノードが待機するアクティブ/パッシブの2つの構成を紹介しています(参考6)。
クラウドでは、冗長性が組み込まれたマネージドサービスを選ぶと、自分で冗長化の仕組みを設計・運用する負担を減らせると説明されています。
アクティブ/アクティブやアクティブ/スタンバイといった冗長構成の方式と選び方は、次の記事で解説しています。
ディスクの冗長化はRAID、ルーターの冗長化はVRRP、回線の束ね方はLACPの記事が参考になります。
ただし、冗長化にはコストがかかり、Microsoftの資料も、冗長性を高めるほどコストが増えるので、慎重に検討し定期的に見直すよう求めています。
同じ資料は、2台で負荷を分け合い、それぞれ60%の使用率で動かしている場合、1台が止まると残りの1台は120%の負荷を処理できないという例も挙げています(参考4)。
並列にしたから安心ではなく、1台が止まっても残りで処理しきれる余裕を持たせておくことが大切です。
5-2. MTTRを縮める:早く気づき、早く復旧する
MTTRを縮めるには、故障に早く気づくこと、原因を早く特定すること、早く元に戻すことの3つが鍵になります。
Microsoftの資料は、回復性の層をいくら重ねても障害は発生するという前提で設計するよう説いています。
故障をゼロにできない以上、起きたときに早く直せる仕組みを用意しておくことが、稼働率を守るもう1つの柱になります。
Microsoftの資料は、障害を見つけるための検出とは、インフラストラクチャやデータ、アプリケーションを監視し、問題が起きたときにアラートを出すことだと説明しています。
同じ資料は、可能な限り検出を自動化し、ビジネス要件を満たすのに十分な速さで対応できるようにするよう勧めています(参考5)。
ネットワーク機器の状態を集めて監視する仕組みとしては、SNMPがよく使われます。
復旧を自動で始めるときの「しきい値」も、事前に決めておく必要があります。
Microsoftの資料は、例として、Webのノードが5分以上使えない場合に新しいノードを自動でプールに追加するという、しきい値の定め方を紹介しています。
同時に、一時的な障害で復旧の操作を早く始めすぎないよう、しきい値の設定では一時的な障害も考慮するよう注意しています(参考1)。
待機系に自動で切り替わる仕組みがあれば、人が駆けつけて修理するのを待たずにサービスを再開できるため、利用者から見たMTTRを大きく縮められます。
切り替えの仕組みと導入の流れは、フェールオーバーの記事で解説しています。
ただし、Microsoftの資料は、プライマリの障害を検出して待機系に切り替えるまでには時間がかかるため、目標復旧時間と切り替えの時間が合っているかを確認するよう求めています(参考3)。
人が対応する部分は、手順書を用意し、誰が見ても同じ順番で復旧できるようにしておくと、担当者による時間のばらつきを減らせます。
障害対応の手順を手順書にまとめる考え方は、インシデント対応プレイブックの記事も参考にしてください。
手順書は作るだけでなく、実際に復旧の訓練をして、かかった時間を測っておくと、現実的なMTTRの目標を決めやすくなります。
5-3. RTO・RPOとの関係と、目標の決め方
MTTRと似た言葉に、RTO(目標復旧時間)とRPO(目標復旧時点)があります。
Microsoftの資料は、RTOを「インシデントの発生後にアプリケーションを使用不可状態にできる最大許容時間」、RPOを「インシデント中のデータ損失の許容される最大期間」と説明しています。
MTTRが過去の故障から求める「実際にかかった復旧時間の平均」であるのに対し、RTOは「ここまでに復旧させたい」という上限の目標だと考えると区別しやすくなります。
同じ資料は、RTO・RPO・MTTR・MTBFを復旧の目標として扱い、事業継続やディザスタリカバリの計画とテストの効果を測る指標だとしています。
バックアップから戻す場合は、復元にかかる時間をRTOに含めて考えるよう、別の資料が注意しています。
また、災害を想定した訓練で復旧の手順を試すことで、RTOが実現できるかを確かめられるとされています。
大規模な災害に備えた復旧の計画は、次の記事で解説しています。
目標を決めるときは、停止によって失う売上や信頼と、稼働率を上げるためのコストを比べることが出発点になります。
Microsoftの資料も、停止が収益にどう影響するかを検討し、その損失を設計と運用のコストと比べたうえで、信頼性にどれだけ費用をかけるかを判断するとしています(参考1)。
RTOとRPOをゼロにしたくなるものの、実際には実装が難しく費用もかかるため、技術と事業の担当者が話し合って現実的な要件を決めることが重要だとされています(参考3)。
まずは現在のMTBFとMTTRを記録して稼働率を計算し、目標との差が「故障の多さ」と「復旧の遅さ」のどちらから来ているかを確かめることから始めましょう。
よくある質問とまとめ
6-1. よくある質問
Q1. MTBFとMTTFの違いは何ですか?
MTBFは修理しながら使い続けるものの故障と故障の間の平均稼働時間で、MTTFは修理せずに交換する部品が使い始めてから故障するまでの平均時間です。
Q2. 稼働率はどうやって計算しますか?
稼働率は「MTBF ÷(MTBF + MTTR)」で求められ、たとえばMTBFが2,918時間、MTTRが2時間なら約99.93%になります。
Q3. MTMFとは何ですか?
MTMFは信頼性の分野で一般的に使われる用語ではなく、多くの場合はMTBF(平均故障間隔)の誤記だと考えられます。
Q4. 稼働率99.9%だと、どれくらい止まりますか?
Microsoftの資料の目安では、99.9%は1か月で約43分、1年で約8.76時間の停止にあたります(参考1)。
Q5. 稼働率を上げるには、MTBFとMTTRのどちらを改善すべきですか?
どちらも稼働率を上げますが、故障をゼロにはできないため、故障を減らす対策や冗長化でMTBF(利用者から見た故障の間隔)を延ばしつつ、監視や自動切り替え、手順書でMTTRを縮める対策を組み合わせるのが現実的です。
6-2. まとめ
MTBFは故障から次の故障までの平均稼働時間、MTTRは故障から復旧までの平均時間、MTTFは交換する部品が故障するまでの平均時間です。
「MTMF」は一般的な用語ではなく、多くの場合はMTBFの誤記と考えられます。
稼働率は「MTBF ÷(MTBF + MTTR)」で求められ、直列の構成は掛け算で下がり、並列の構成は予備によって上がります。
SLAの稼働率は契約上の約束なので、対象範囲を確かめたうえで、自社システム全体の稼働率を見積もりましょう。
まずは身近なシステムの故障と復旧の記録を集め、MTBFとMTTRを計算するところから始めてください。
参考1:信頼性ターゲットを定義するためのアーキテクチャ戦略(Microsoft Learn)
参考2:Architecture strategies for defining reliability targets(Microsoft Learn)
参考3:ビジネス継続性、高可用性、ディザスター リカバリーとは(Microsoft Learn)
参考4:冗長性を設計するためのアーキテクチャ戦略(Microsoft Learn)
参考5:障害モード分析を実行するためのアーキテクチャ戦略(Microsoft Learn)
参考6:Windows Server と Azure Local でのフェールオーバー クラスタリング(Microsoft Learn)